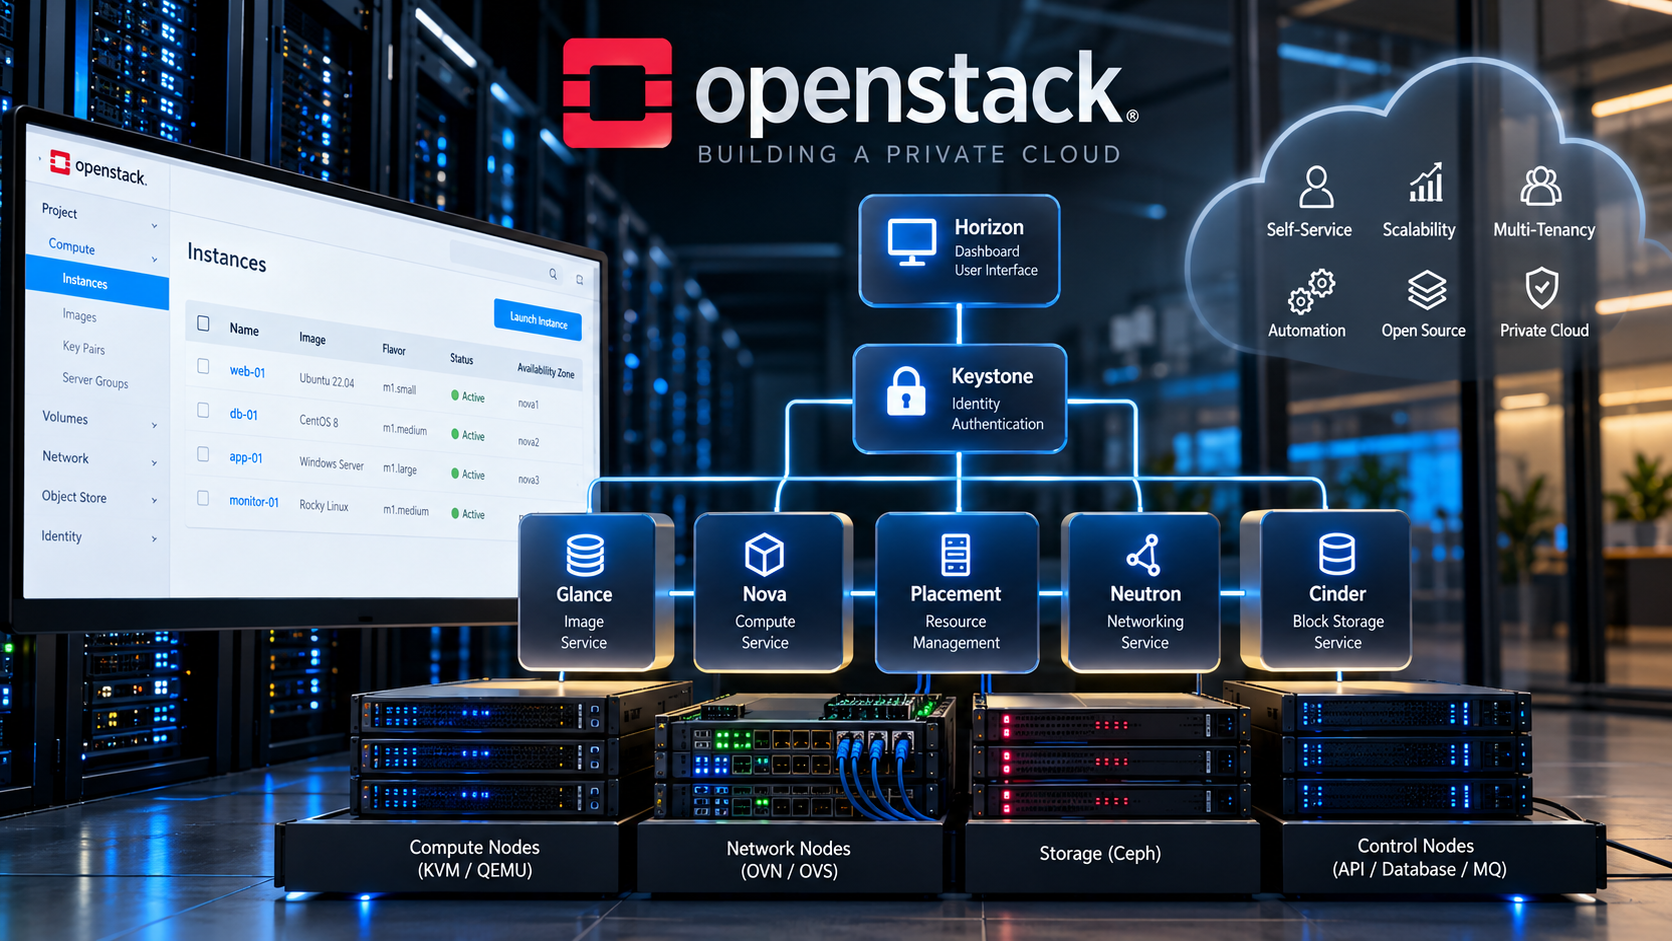
وقتی برای اولین بار با معماری OpenStack آشنا شدم، سرویسهایی مثل Nova، Neutron، Glance و Keystone خیلی زود قابل درک بودند. اسم هرکدام تقریباً نشان میداد با چه بخشی از Cloud سروکار داریم.
اما Placement برای من اینطور نبود.
تعریف اولیهاش هم در ظاهر ساده بود: سرویسی برای مدیریت و ردیابی Resourceها.
مشکل از جایی شروع میشود که یک Instance میسازیم و Nova اعلام میکند Host مناسبی برای اجرای آن پیدا نشده است؛ در حالی که وقتی وارد Compute Node میشویم، CPU و RAM آزاد داریم.
اینجا یک سؤال مهم ایجاد میشود:
اگر روی سرور Resource آزاد وجود دارد، چرا OpenStack نمیتواند VM را روی آن قرار دهد؟
پاسخ این سؤال یکی از مهمترین تفاوتهای میان «Resource واقعی روی سرور» و «Resourceای که OpenStack میشناسد» را نشان میدهد.
Placement دقیقاً در همین نقطه اهمیت پیدا میکند.
Placement را نباید فقط یک Database از CPU و RAM دید
برای فهم Placement ابتدا باید یک تصور اشتباه را کنار بگذاریم.
فرض کنیم سه Compute Node داریم:
compute01
compute02
compute03
هرکدام دارای CPU و RAM مشخصی هستند.
ممکن است تصور کنیم Nova هنگام ساخت Instance به این سرورها وصل میشود، free یا lscpu اجرا میکند، Resource آزاد را پیدا میکند و VM را روی یکی از آنها قرار میدهد.
معماری OpenStack اینطور کار نمیکند.
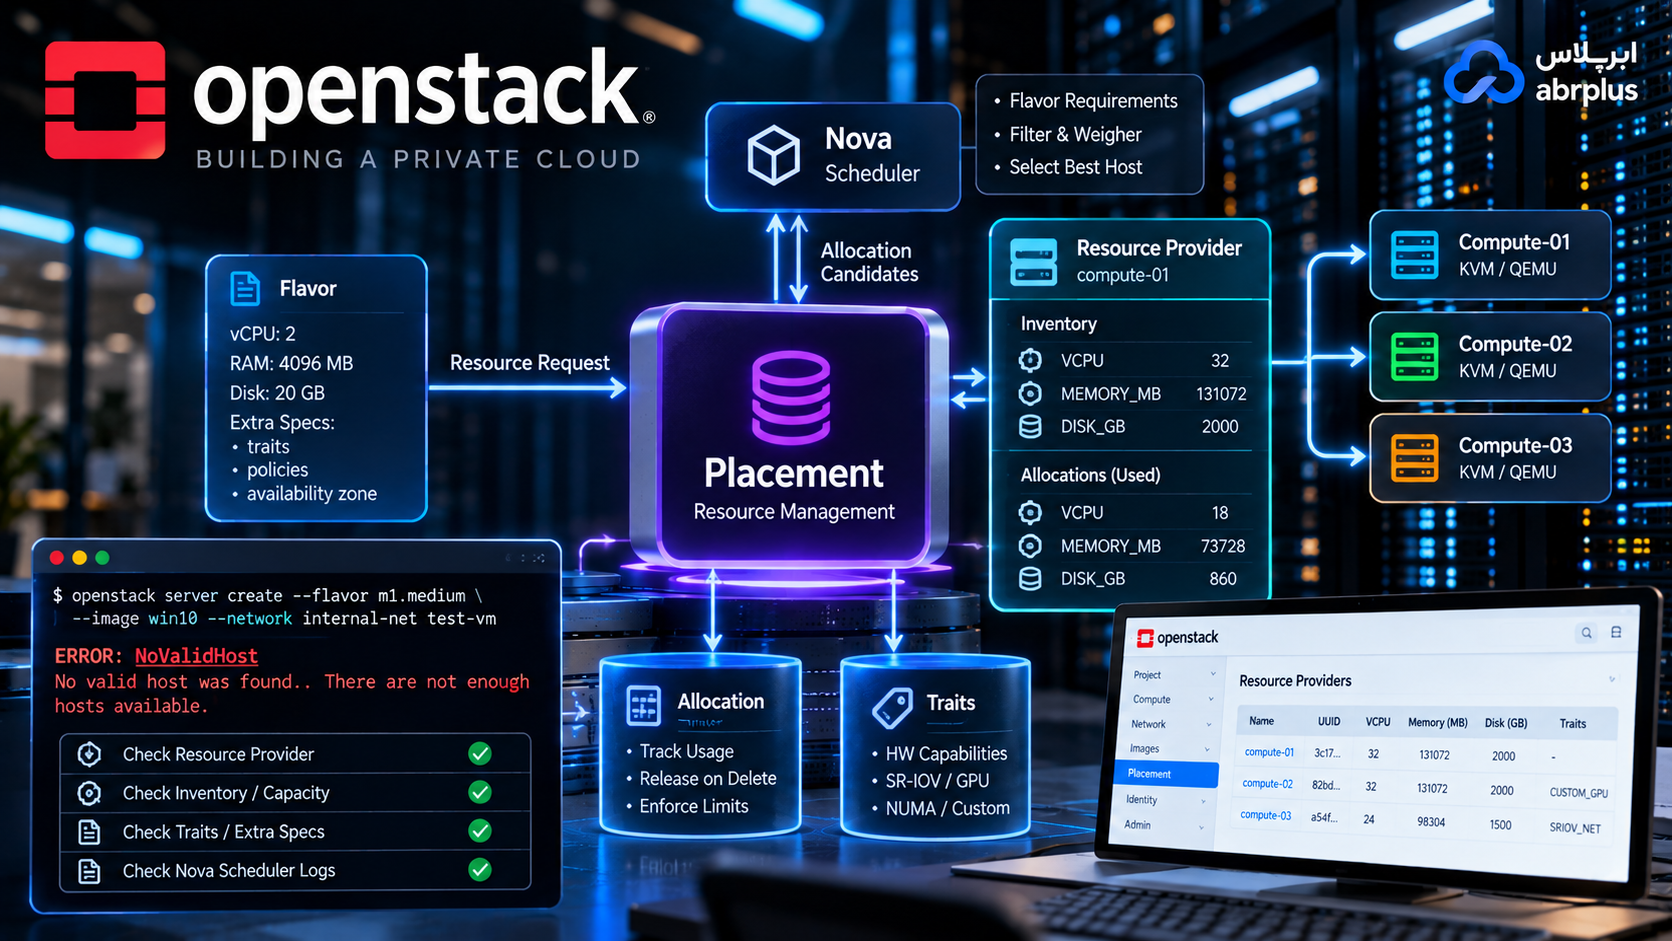
OpenStack یک مدل منطقی از Resourceهای Infrastructure نگه میدارد.
Placement بخشی اساسی از این مدل است.
در Placement مفاهیمی مثل:
Resource Provider
Inventory
Allocation
Resource Class
Trait
Allocation Candidate
وجود دارند.
وقتی این مفاهیم را بفهمیم، خطاهایی مثل NoValidHost هم بسیار قابلفهمتر میشوند.
Resource Provider چیست؟
یکی از اولین مفاهیم Placement، Resource Provider است.
در سادهترین سناریو میتوان Compute Node را یک Resource Provider در نظر گرفت.
برای مثال:
compute01
ممکن است Inventoryهایی مانند این داشته باشد:
VCPU
MEMORY_MB
DISK_GB
اما Placement محدود به Compute Node نیست.
در معماریهای پیچیدهتر Resource Provider میتواند ساختار Parent/Child داشته باشد و Resourceهای دیگری مثل NUMA، SR-IOV یا Acceleratorها را مدل کند.
برای مشاهده Resource Providerها میتوان از OpenStack CLI استفاده کرد.
مثلاً:
openstack resource provider list
خروجی ممکن است چیزی شبیه این باشد:
+--------------------------------------+-----------+
| uuid                                 | name      |
+--------------------------------------+-----------+
| 3c17...                              | compute01 |
| 82bd...                              | compute02 |
| a54f...                              | compute03 |
+--------------------------------------+-----------+
اگر Compute Node مورد انتظار من در این لیست وجود نداشته باشد، قبل از بررسی میزان RAM آزاد، یک مشکل بنیادیتر داریم.
Inventory؛ چه Resourceهایی در اختیار Placement قرار گرفتهاند؟
وجود Resource Provider بهتنهایی کافی نیست.
Placement باید بداند Provider چه Resourceهایی ارائه میکند.
برای بررسی:
openstack resource provider inventory list <RESOURCE_PROVIDER_UUID>
اینجا ممکن است Resource Classهایی مثل اینها را ببینیم:
VCPU
MEMORY_MB
DISK_GB
هر Inventory نیز فقط یک عدد ساده نیست.
پارامترهایی مثل:
total
reserved
min_unit
max_unit
step_size
allocation_ratio
میتوانند در محاسبه Capacity مؤثر باشند.
این موضوع بسیار مهم است، چون Capacity از دید Placement الزاماً همان چیزی نیست که با ابزارهای Linux روی Host مشاهده میکنیم.
چرا free -h همیشه جواب سؤال ما را نمیدهد؟
فرض کنیم روی Compute اجرا میکنیم:
free -h
و میبینیم چندین گیگابایت RAM آزاد وجود دارد.
بعد Flavor ما فقط 4GB RAM میخواهد.
اما Instance ساخته نمیشود.
اولین واکنش ممکن است این باشد:
«Nova اشتباه میکند؛ RAM که داریم.»
اما اینجا داریم دو دید مختلف از Resource را با هم مقایسه میکنیم.
Linux وضعیت فعلی Memory سیستمعامل را نشان میدهد.
Placement براساس Inventory، Allocation و سیاستهای Capacity تصمیم میگیرد.
این دو الزاماً یکی نیستند.
مثلاً بخشی از Resource میتواند Reserved باشد.
یا Allocationهای موجود باعث شده باشند ظرفیت قابل تخصیص از دید OpenStack کمتر از چیزی باشد که در Host مشاهده میکنیم.
بنابراین در Troubleshooting Scheduling فقط بررسی Host OS کافی نیست.
Allocation چیست؟
اگر Inventory بگوید چه Resourceهایی داریم، Allocation نشان میدهد چه مقدار از آن Resourceها مصرف شدهاند.
فرض کنیم Instanceای داریم با:
2 vCPU
4096 MB RAM
20 GB Disk
وقتی این Instance روی Compute قرار میگیرد، Placement باید Allocation مربوط به Resourceهای آن را ثبت کند.
در نتیجه Placement فقط Capacity کل را نمیشناسد؛ مصرف Resource توسط Workloadها را نیز دنبال میکند.
همین موضوع برای Scheduler اهمیت زیادی دارد.
وقتی Instance جدید درخواست میشود، باید مشخص شود چه Resourceهایی لازم دارد و کدام Resource Provider میتواند آنها را تأمین کند.
Flavor از کجا وارد داستان Placement میشود؟
وقتی Flavor میسازیم:
openstack flavor create \
  --ram 4096 \
  --disk 20 \
  --vcpus 2 \
  m1.medium
عملاً بخشی از Resource Requirement ماشین را تعریف کردهایم.
وقتی Instance با این Flavor ساخته میشود، Nova باید Hostی پیدا کند که Requirementهای لازم را برآورده کند.
بهصورت مفهومی:
Flavor
   ↓
Resource Request
   ↓
Placement
   ↓
Allocation Candidates
   ↓
Nova Scheduler
   ↓
Selected Compute
این Flow کمک میکند بفهمیم چرا Placement و Scheduler یک چیز نیستند.
Placement اطلاعات و Candidateهای Resource را فراهم میکند.
Nova Scheduler براساس Candidateها و Filter/Weigherهای خودش تصمیمگیری میکند.
Placement با Nova Scheduler چه تفاوتی دارد؟
این دو را خیلی راحت میشود با هم اشتباه گرفت.
Placement نمیگوید:
حتماً VM را روی compute02 بساز.
Placement بیشتر به این سؤال پاسخ میدهد:
کدام Resource Providerها از نظر Resource Requirement میتوانند این درخواست را پاسخ دهند؟
بعد Scheduler از میان Candidateهای معتبر انتخاب انجام میدهد.
به شکل ساده:
User Request
     ↓
Nova API
     ↓
Resource Requirement
     ↓
Placement
     ↓
Candidate Providers
     ↓
Nova Scheduler
     ↓
Selected Host
     ↓
Nova Compute
این معماری در Troubleshooting بسیار مهم است.
اگر Candidate وجود نداشته باشد، مسئله با حالتی که Candidate داریم ولی Scheduler آنها را Reject میکند متفاوت است.
NoValidHost؛ خطایی که خودش Root Cause نیست
یکی از خطاهای شناختهشده در Nova:
NoValidHost
است.
اسم خطا ممکن است این تصور را ایجاد کند که:
«هیچ Compute Node سالمی وجود ندارد.»
اما این برداشت دقیق نیست.
NoValidHost بیشتر میگوید Nova نتوانسته Host مناسبی برای Requirement فعلی پیدا کند.
دلیل آن میتواند بسیار متفاوت باشد:
RAM کافی از دید Placement وجود ندارد.
VCPU Capacity کافی نیست.
Disk Requirement تأمین نمیشود.
Trait موردنیاز وجود ندارد.
Availability Zone اشتباه است.
Host Aggregate محدودیت ایجاد کرده.
Compute Service Down است.
Placement Inventory مشکل دارد.
Resource Provider درست ثبت نشده.
Allocation وضعیت ناسازگاری دارد.
Flavor Extra Spec باعث حذف Candidateها شده.
بنابراین:
NoValidHost تشخیص نهایی نیست؛ نقطه شروع Investigation است.
وقتی NoValidHost میبینم، مستقیم سراغ Restart نمیروم
این یکی از الگوهایی است که در OpenStack سعی میکنم رعایت کنم.
Restart کردن Nova Scheduler ممکن است در بعضی خرابیها لازم شود، ولی NoValidHost بهتنهایی هیچ دلیلی برای Restart کردن سرویس نیست.
ابتدا وضعیت Computeها را بررسی میکنم:
openstack compute service list
اگر nova-compute روی Host موردنظر Down باشد، یک مسیر Troubleshooting داریم.
بعد:
openstack hypervisor list
اگر Hypervisor اصلاً دیده نمیشود، مسئله با حالتی که Hypervisor Up است ولی Capacity مناسب ندارد فرق میکند.
بعد Placement:
openstack resource provider list
حالا میتوانیم ببینیم Compute بهعنوان Resource Provider وجود دارد یا خیر.
Inventory را بررسی میکنم، نه فقط Hardware را
بعد از پیدا کردن UUID مربوط به Compute:
openstack resource provider inventory list <UUID>
این خروجی میتواند خیلی چیزها را روشن کند.
فرض کنید Server فیزیکی 128GB RAM دارد.
این به معنی آن نیست که Placement دقیقاً 128GB Resource قابل تخصیص میبیند.
Reserved Memory، Allocation و تنظیمات دیگر میتوانند وضعیت را تغییر دهند.
همین مسئله درباره CPU نیز وجود دارد.
پس به جای:
سرور 32 Core دارد.
سؤال دقیقتر این است:
Placement برای این Resource Provider چه Inventoryای ثبت کرده و چه مقدار از آن Allocate شده است؟
این تغییر سؤال در Troubleshooting بسیار مهم است.
Resource Class؛ همه Resourceها CPU و RAM نیستند
یکی از قسمتهای جالب Placement مفهوم Resource Class است.
نمونههای معمول:
VCPU
MEMORY_MB
DISK_GB
اما OpenStack میتواند Resourceهای تخصصیتری را هم مدل کند.
این قابلیت وقتی Infrastructure پیچیدهتر شود اهمیت زیادی پیدا میکند.
مثلاً در محیطهایی که:
SR-IOV
GPU
FPGA
NUMA-aware workloads
PCI devices
داریم، Scheduling دیگر فقط مسئله «کدام Host RAM بیشتری دارد» نیست.
Placement کمک میکند Requirementهای Resource بهشکل ساختاریافته مدل شوند.
Trait چیست و چرا اهمیت دارد؟
Trait راهی برای بیان Capability یا ویژگی Resource Provider است.
فرض کنید بعضی Compute Nodeها ویژگی خاصی دارند.
Workload ممکن است نیاز داشته باشد فقط روی Hostهایی اجرا شود که آن ویژگی را دارند.
در این حالت فقط Capacity کافی نیست.
Host باید Capability موردنیاز را هم داشته باشد.
برای مشاهده Traitهای Provider:
openstack resource provider trait list <RESOURCE_PROVIDER_UUID>
اینجاست که یک NoValidHost میتواند جالب شود.
ممکن است Compute CPU و RAM کافی داشته باشد ولی Trait موردنیاز Flavor یا Workload را نداشته باشد.
از دید Administrator سرور «خالی» است.
از دید Scheduler برای آن Workload «مناسب» نیست.
این دو جمله تناقض ندارند.
Flavor Extra Specs میتوانند Scheduling را کاملاً تغییر دهند
فرض کنیم Flavor فقط این نیست:
4 vCPU
8GB RAM
40GB Disk
ممکن است Extra Spec هم داشته باشد.
برای مشاهده:
openstack flavor show <FLAVOR>
در محیطهای Production این قسمت را نباید نادیده گرفت.
Extra Specها میتوانند Scheduling Constraint ایجاد کنند.
بنابراین اگر یک Flavor کار میکند ولی Flavor دیگری روی همان Cloud NoValidHost میدهد، یکی از سؤالهای من این است:
تفاوت فقط Resource Size است یا Extra Spec هم فرق دارد؟
این مقایسه گاهی سریعتر از خواندن صدها خط Log ما را به Root Cause نزدیک میکند.
یک روش ساده برای Troubleshooting: مسئله را کوچک کنم
فرض کنیم Instance با Flavor اصلی ساخته نمیشود.
به جای تغییر چند Configuration همزمان، ممکن است یک Flavor سادهتر را امتحان کنم.
مثلاً:
openstack flavor create \
  --ram 2048 \
  --disk 10 \
  --vcpus 1 \
  placement-test
بعد یک Instance آزمایشی.
اگر Flavor کوچک کار کند ولی Flavor اصلی Fail شود، اطلاعات مهمی به دست آوردهایم.
مشکل احتمالاً کلی نیست.
Compute کاملاً از دسترس خارج نشده.
Nova میتواند Instance بسازد.
Image قابل استفاده است.
Network احتمالاً مانع اولیه نیست.
حالا Investigation را روی Resource Requirement و Scheduling Constraint متمرکز میکنیم.
این برای من بسیار ارزشمندتر از Restart کردن تصادفی سرویسهاست.
Physical Capacity و Cloud Capacity یک چیز نیستند
این شاید مهمترین مفهوم مقاله باشد.
فرض کنیم Host:
128 GB RAM
32 CPU Core
2 TB Disk
دارد.
این اعداد Physical Capacity هستند.
اما Cloud Capacity تحت تأثیر موارد دیگری قرار میگیرد:
Reserved Resources
Allocation Ratio
Existing Allocations
Resource Classes
Traits
Scheduling Policies
Host Aggregates
Availability Zones
Flavor Requirements
بنابراین معماری Cloud یک لایه منطقی روی Hardware ایجاد میکند.
همین موضوع یکی از دلایلی است که OpenStack را نباید صرفاً یک Virtualization Manager دانست.
Placement API؛ وقتی میخواهم یک لایه عمیقتر بروم
CLI برای بسیاری از بررسیها کافی است، اما دانستن اینکه Placement خودش API دارد کمک میکند معماری را بهتر بفهمیم.
در واقع Nova برای Resource Tracking و Candidateها با Placement API کار میکند.
این موضوع یک نکته Troubleshooting مهم ایجاد میکند:
ممکن است Nova Service سالم باشد ولی ارتباط آن با Placement مشکل داشته باشد.
در چنین شرایطی فقط دیدن:
openstack compute service list
کافی نیست.
Compute Up بودن به معنی سالم بودن تمام Dependencyهای Nova نیست.
دقیقاً همان چیزی که در Keystone یاد گرفتیم:
Service Up ≠ End-to-End Healthy
Authentication بین Nova و Placement هم اهمیت دارد
Placement یک جزیره مستقل نیست.
Nova باید بتواند به API آن دسترسی داشته باشد.
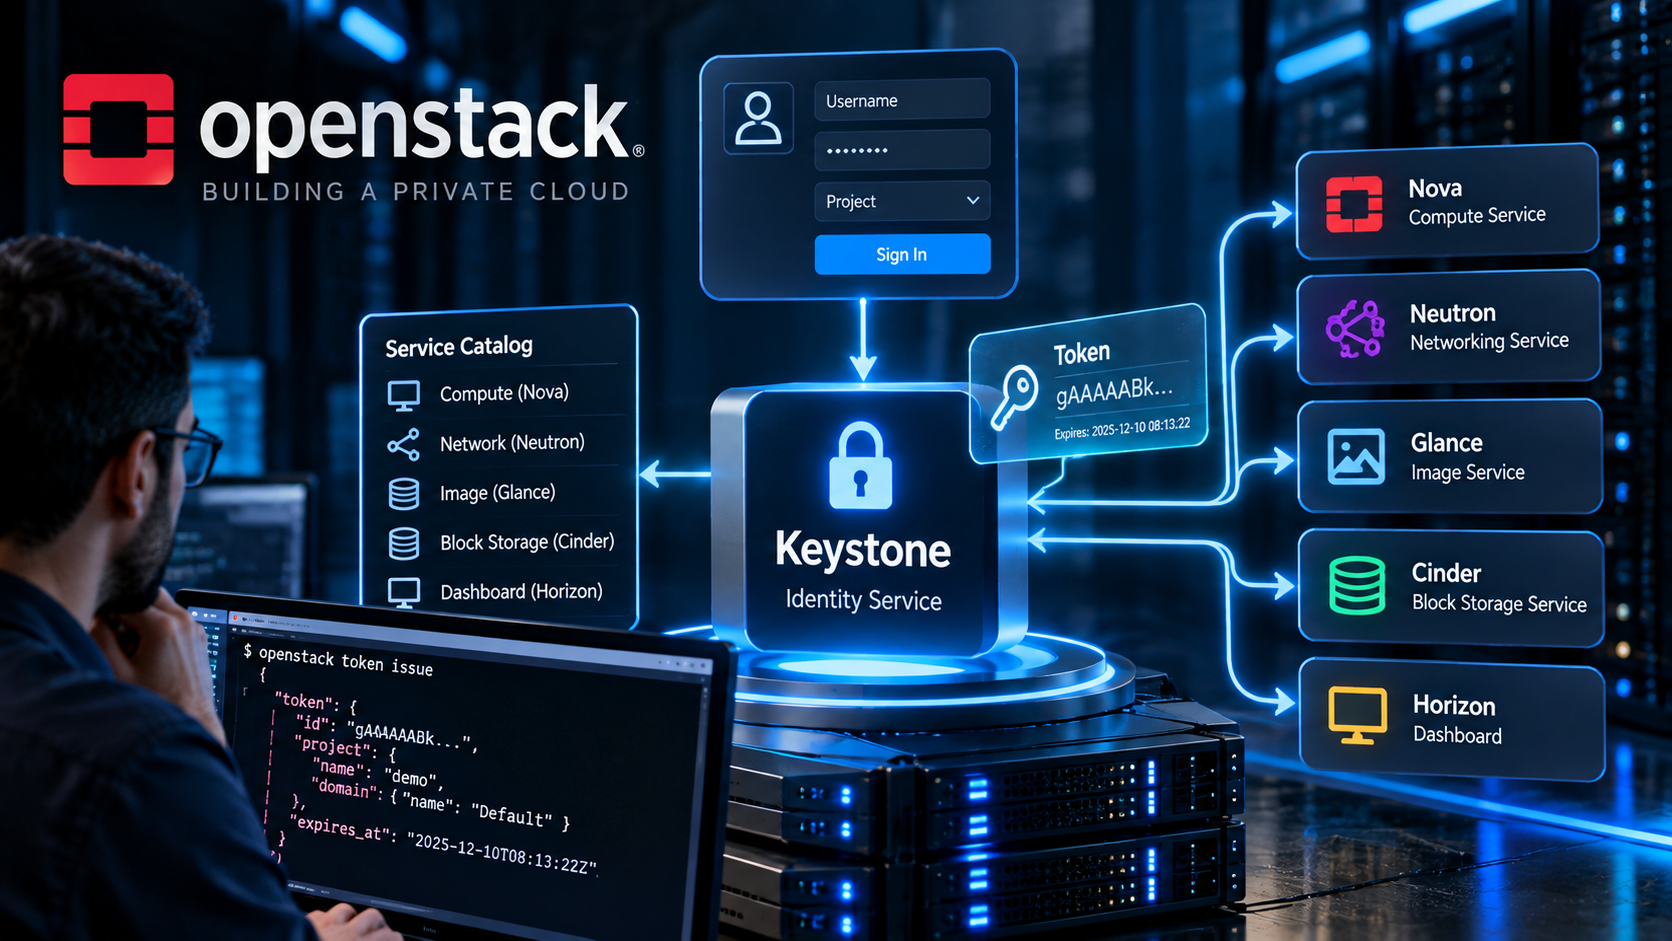
بنابراین Keystone و Service Credentialها دوباره وارد ماجرا میشوند.
این دقیقاً جایی است که Content Cluster مقالات به هم متصل میشود.
در مقاله Keystone گفتیم Authentication فقط برای User انسانی نیست.
Serviceها نیز برای ارتباط با یکدیگر Credential دارند.
اگر Nova نتواند با Placement ارتباط صحیح برقرار کند، Scheduling میتواند تحت تأثیر قرار بگیرد.
پس وقتی Log خطای Authentication نشان میدهد، افزایش RAM Compute هیچ کمکی نمیکند.
Logها؛ وقتی CLI دیگر کافی نیست
بعد از بررسی وضعیت کلی، اگر هنوز Root Cause مشخص نباشد، سراغ Log میروم.
برای Scheduling، nova-scheduler اهمیت زیادی دارد.
دنبال پیامهایی درباره:
NoValidHost
AllocationCandidates
Placement
ResourceProvider
Insufficient resources
Filter
Trait
میگردم.
نکته مهم این است که فقط آخرین خط Log را نخوانم.
NoValidHost ممکن است نتیجه نهایی چند Filter یا Constraint قبلی باشد.
باید چند خط قبلتر را هم ببینیم تا بفهمیم Candidateها در کدام مرحله حذف شدهاند.
یک سناریوی واقعی از نوع تفکری که استفاده میکنم
فرض کنیم کاربر میگوید:
VM ساخته نمیشود ولی Compute من 64GB RAM آزاد دارد.
به جای اینکه بگویم:
پس Nova مشکل دارد.
مسیر را اینطور میشکنم:
1. آیا Compute Up است؟
openstack compute service list
2. آیا Hypervisor دیده میشود؟
openstack hypervisor list
3. آیا Resource Provider وجود دارد؟
openstack resource provider list
4. Inventory چیست؟
openstack resource provider inventory list <UUID>
5. Flavor چه میخواهد؟
openstack flavor show <FLAVOR>
6. آیا Constraint اضافه داریم؟
Extra Spec؟
Trait؟
Aggregate؟
AZ؟
7. Scheduler چه میگوید؟
حالا Log را بررسی میکنم.
این ترتیب به نظرم بسیار منطقیتر از:
restart nova
restart rabbitmq
restart placement
و امید داشتن به اینکه مشکل حل شود است.
Allocationهای ناسازگار؛ چرا State مهم است؟
در سیستمهای Distributed، State همیشه چیزی نیست که از یک Command واحد بتوان فهمید.
ممکن است Resource Provider وجود داشته باشد.
Inventory هم درست باشد.
ولی Allocationها چیزی متفاوت از انتظار ما نشان دهند.
این مسئله مخصوصاً بعد از Failure، Migration، تغییر Host یا عملیات غیرعادی میتواند ارزش بررسی داشته باشد.
اصل مهم این است:
Placement منبع حقیقت Resource Tracking برای Scheduling است.
بنابراین اگر تصور Administrator از مصرف Resource با State ثبتشده در Placement فرق داشته باشد، Scheduler براساس تصور Administrator تصمیم نمیگیرد.
براساس State خودش تصمیم میگیرد.
Placement در Migration هم مهم میشود
وقتی درباره مهاجرت VM صحبت میکنیم، معمولاً تمرکز روی Disk و Network است.
اما مقصد باید Resource لازم را هم داشته باشد.
در پروژههای Migration این مسئله در Scale بزرگتر بسیار مهم میشود.
اگر قرار باشد دهها یا صدها VM وارد OpenStack شوند، فقط مجموع CPU و RAM فیزیکی را جمع کردن کافی نیست.
باید درباره:
Overcommit
Reserved Capacity
Failure Capacity
Flavor Distribution
Resource Allocation
Growth
HA
هم فکر کنیم.
Placement دقیقاً به همین لایه Resource Management مربوط است.
Placement چه چیزی درباره Capacity Planning به من یاد داد؟
در Virtualization سنتی ممکن است Capacity Planning را با جدولهایی مثل این شروع کنیم:
Total CPU
Used CPU
Total RAM
Used RAM
Storage Used
این اطلاعات هنوز مهماند.
اما در Cloud باید یک سؤال دیگر هم اضافه شود:
Scheduler چه مقدار از این Capacity را قابل مصرف میبیند؟
این سؤال برای من بسیار مهمتر شد.
چون چیزی که Hardware دارد الزاماً چیزی نیست که Cloud میتواند Allocate کند.
Checklist من برای NoValidHost
اگر بخواهم مسیر Troubleshooting را خلاصه کنم، از این Checklist استفاده میکنم.
Compute Service
openstack compute service list
آیا Compute Up است؟
Hypervisor
openstack hypervisor list
آیا Hypervisor ثبت شده؟
Resource Provider
openstack resource provider list
آیا Provider وجود دارد؟
Inventory
openstack resource provider inventory list <UUID>
آیا VCPU، MEMORY_MB و Resourceهای موردنیاز صحیحاند؟
Flavor
openstack flavor show <FLAVOR>
Requirement واقعی چیست؟
Traits
openstack resource provider trait list <UUID>
آیا Capability موردنیاز وجود دارد؟
Constraints
بررسی میکنم:
Availability Zone
Host Aggregate
Extra Specs
Traits
Resource Requirement
Logs
در نهایت:
Nova Scheduler
Placement
Nova Compute
را براساس یافتههای قبلی بررسی میکنم.
این ترتیب مهم است؛ چون Log باید برای پاسخ دادن به یک سؤال مشخص خوانده شود، نه اینکه هزاران خط Log را بدون فرضیه مرور کنیم.
Placement چه تغییری در نگاه من به Troubleshooting OpenStack ایجاد کرد؟
Placement یک درس مهم برای من داشت:
وضعیت فیزیکی Infrastructure فقط بخشی از حقیقت است.
ممکن است یک سرور روشن باشد.
ممکن است Linux آن سالم باشد.
ممکن است KVM کار کند.
ممکن است 50GB RAM آزاد داشته باشد.
ممکن است CPU تقریباً Idle باشد.
ولی هیچکدام بهتنهایی ثابت نمیکنند که OpenStack میتواند Workload جدیدی روی آن Schedule کند.
Cloud یک مدل Resource از Infrastructure دارد.
Nova و Placement براساس همین مدل تصمیم میگیرند.
به همین دلیل وقتی NoValidHost میبینم، دیگر اولین سؤال من این نیست:
«کدام سرور Resource آزاد دارد؟»
سؤال دقیقتر این است:
«چرا OpenStack این Resource Provider را Candidate معتبر برای این Workload نمیبیند؟»
همین تغییر کوچک در نوع سؤال، Troubleshooting را از حدس زدن به تحلیل معماری تبدیل میکند.
و به نظرم Placement دقیقاً یکی از سرویسهایی است که تفاوت بین «داشتن چند Hypervisor» و «ساختن یک Cloud» را بهتر نشان میدهد