Ceph چیست
sfsdfdf
مطالعه مقاله ←در این مقاله OpenStack را نه صرفاً از روی تعریف سرویسها، بلکه از تجربه راهاندازی و عیبیابی بررسی میکنم؛ از ارتباط Keystone، Nova، Placement، Glance و Neutron تا Kolla-Ansible، شبکه OVN/OVS و روشی که برای Troubleshooting مرحلهبهمرحله OpenStack به آن رسیدم.
وقتی برای اولین بار سراغ OpenStack رفتم، تصورم این بود که با یک پلتفرم مجازیسازی روبهرو هستم که قرار است کاری شبیه VMware انجام دهد؛ چند Host داشته باشیم، ماشین مجازی بسازیم، Network و Storage را متصل کنیم و در نهایت همهچیز را از یک Dashboard مدیریت کنیم.
اما وقتی وارد پیادهسازی شدم، متوجه شدم این نگاه بخش بزرگی از معماری OpenStack را پنهان میکند.
OpenStack را نمیتوان فقط جایگزینی برای vCenter یا یک Hypervisor دیگر دانست. OpenStack در اصل مجموعهای از سرویسهای مستقل است که با همکاری یکدیگر یک Cloud Infrastructure میسازند.
در VMware معمولاً بخش زیادی از پیچیدگی زیرساخت پشت vCenter و ESXi پنهان شده است. در OpenStack این اجزا واضحتر و مستقلتر هستند. Authentication یک سرویس دارد، Compute سرویس خودش را دارد، Network توسط سرویس دیگری مدیریت میشود و Image و Storage هم اجزای جداگانهای هستند.
همین معماری یکی از نقاط قوت OpenStack است؛ ولی از طرف دیگر باعث میشود Troubleshooting آن با یک محیط مجازیسازی سنتی متفاوت باشد.
این موضوع را زمانی بهتر فهمیدم که اولین Labهای OpenStack را راهاندازی کردم.
یکی از اشتباهاتی که در ابتدای کار داشتم این بود که OpenStack را بهعنوان یک Product واحد نگاه میکردم.
مثلاً در محیط VMware وقتی میگوییم vSphere، تقریباً میدانیم با چه مجموعهای از Componentها سروکار داریم.
اما OpenStack بیشتر شبیه یک اکوسیستم از سرویسهاست.
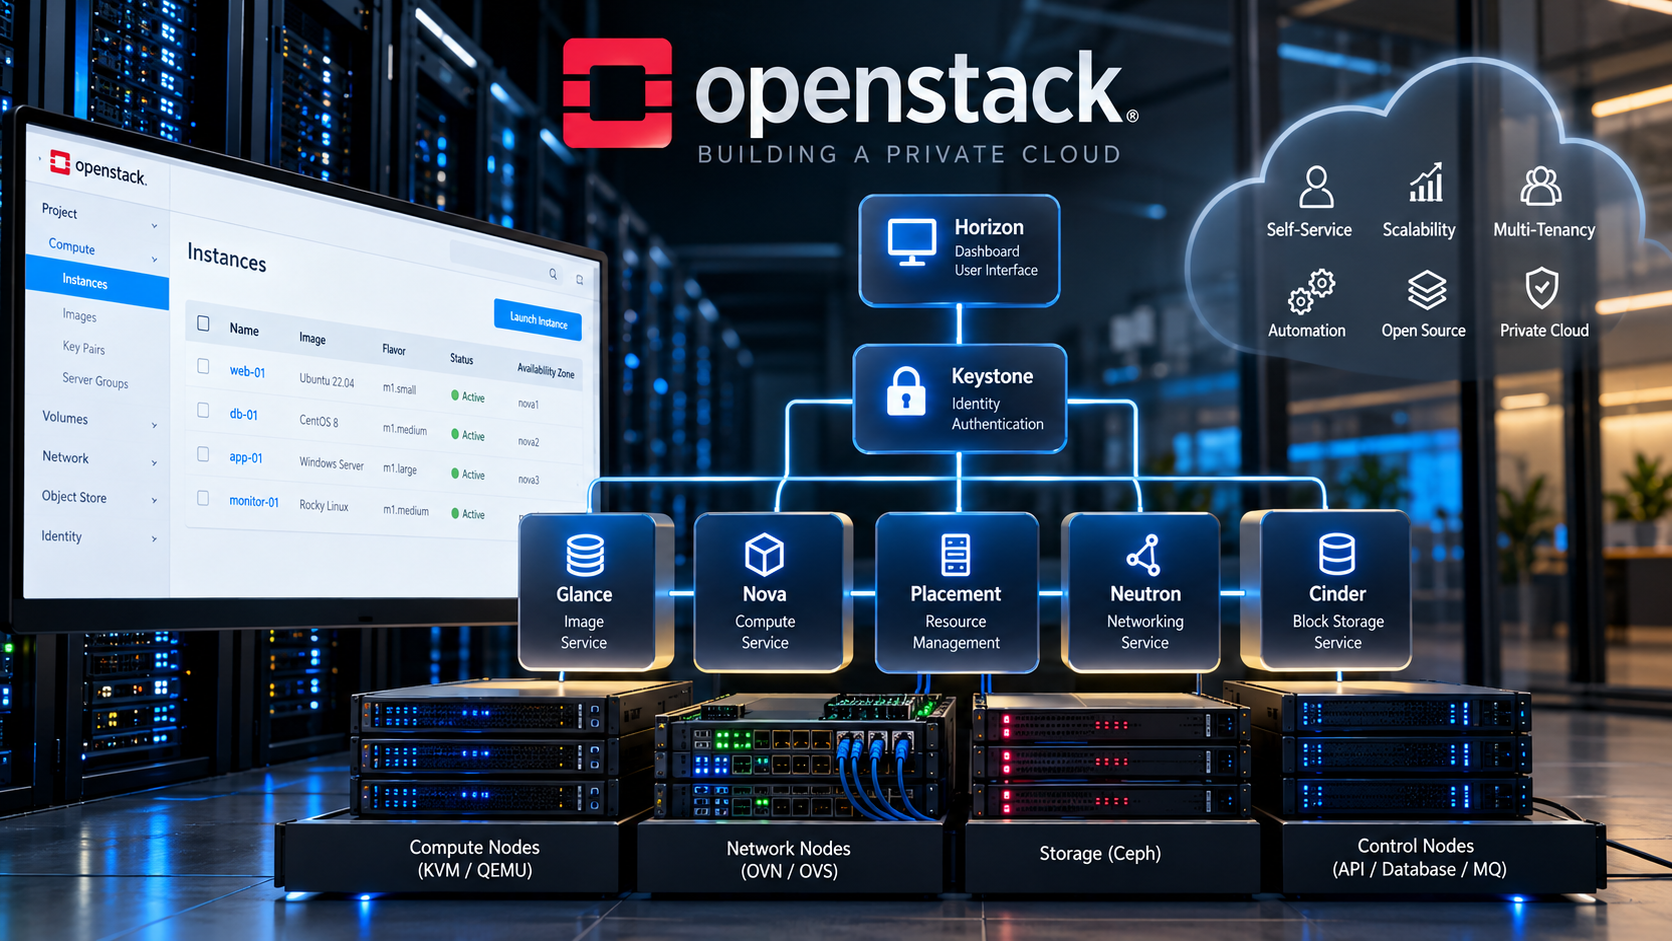
برای یک Cloud پایه حداقل با سرویسهایی مثل اینها سروکار داریم:
Keystone برای Identity و Authentication
Glance برای مدیریت Image
Nova برای Compute
Placement برای مدیریت Inventory و تخصیص Resource
Neutron برای Networking
و معمولاً در کنار آنها:
Cinder برای Block Storage
Horizon برای Dashboard
قرار میگیرند.
نکته مهم این است که این سرویسها فقط کنار هم نصب نشدهاند؛ دائماً با یکدیگر ارتباط دارند.
برای همین اگر یک VM ساخته نمیشود، الزاماً مشکل از Nova نیست.
ممکن است مشکل از Authentication باشد.
ممکن است Nova نتواند Resource مناسب را از طریق Placement پیدا کند.
ممکن است Port شبکه در Neutron ایجاد نشود.
ممکن است Image در Glance در دسترس نباشد.
یا حتی همه این موارد درست باشند ولی Hypervisor در مرحله Spawn کردن Instance خطا بدهد.
این دقیقاً جایی بود که نگاه من به Troubleshooting در OpenStack تغییر کرد.
برای درک OpenStack، به نظرم یکی از بهترین تمرینها این است که به جای حفظ کردن تعریف سرویسها، مسیر ایجاد یک Instance را دنبال کنیم.
فرض کنیم وارد Horizon شدهایم و میخواهیم یک VM بسازیم.
در ظاهر چند فیلد انتخاب میکنیم:
Image
Flavor
Network
Security Group
و در نهایت:
Launch Instance
اما پشت این دکمه مجموعهای از ارتباطات اتفاق میافتد.
بهصورت سادهشده میتوان مسیر را اینطور دید:
Horizon
↓
Keystone
↓
Nova API
↓
Placement
↓
Glance
↓
Neutron
↓
Nova Compute
↓
Hypervisor
البته معماری واقعی جزئیات بیشتری دارد، ولی برای فهم اولیه این Flow بسیار مهم است.
اول باید Identity کاربر تأیید شود.
بعد درخواست Compute وارد Nova میشود.
Nova باید بفهمد کدام Compute Node منابع لازم را دارد.
برای این قسمت Placement نقش مهمی دارد.
بعد Image باید قابل دسترس باشد.
Network Port باید ایجاد شود.
و در نهایت Compute Node باید VM را روی Hypervisor ایجاد کند.
وقتی این Flow را بفهمیم، Troubleshooting بسیار منطقیتر میشود.
به جای اینکه با دیدن:
ERROR
شروع کنیم به Restart کردن سرویسها، میتوانیم بپرسیم:
درخواست دقیقاً در کدام مرحله متوقف شده است؟
این سؤال یکی از مهمترین چیزهایی است که کار با OpenStack به من یاد داد.
در یکی از Labهای اولیه من، Keystone یکی از اولین سرویسهایی بود که باعث شد اهمیت ارتباط بین سرویسهای OpenStack را واقعاً درک کنم.
Keystone مسئول Identity است.
User، Project، Role، Token و Service Catalog همگی به نوعی با Keystone مرتبط هستند.
در یکی از تستها Endpoint مربوط به Keystone در شرایطی قرار گرفته بود که درخواست به آدرس مورد انتظار نمیرسید و پاسخ درست API دریافت نمیشد.
نتیجه در ظاهر میتوانست این تصور را ایجاد کند که مشکل از Client یا حتی سرویس دیگری است.
اما مسئله اصلی در مسیر دسترسی به Identity API بود.
یکی از تستهای پایهای که بعدها برایم تبدیل به یک Check مهم شد این بود:
openstack token issue
اگر این دستور نتواند Token معتبر دریافت کند، قبل از اینکه سراغ Nova و Neutron و بقیه سرویسها بروم، ابتدا Authentication و Endpointها را بررسی میکنم.
مثلاً:
openstack endpoint listو:openstack service list
این دو دستور ساده دید بسیار خوبی از Service Catalog میدهند.
تجربه من این بود که در OpenStack نباید صرفاً بررسی کنیم یک Process یا Container در حال اجراست.
ممکن است Keystone بالا باشد، اما Endpoint اشتباه باشد.
ممکن است Endpoint درست باشد، ولی TLS یا Reverse Proxy مشکل داشته باشد.
ممکن است API پاسخ بدهد، ولی Credential یا Scope اشتباه باشد.
بنابراین:
Running بودن سرویس مساوی Healthy بودن سرویس نیست.
در نگاه اول Nova همان Compute Service است.
اما وقتی عمیقتر وارد آن میشویم، متوجه میشویم ایجاد Instance یک عملیات چندمرحلهای است.
یکی از اشتباهات رایج در Troubleshooting این است که وقتی VM ساخته نمیشود مستقیم سراغ Compute Node برویم.
در حالی که ممکن است Scheduler اصلاً Compute مناسبی انتخاب نکرده باشد.
یکی از اولین بررسیهای من در چنین شرایطی وضعیت Compute Serviceهاست:
openstack compute service listبعد وضعیت Hypervisorها:
openstack hypervisor listاگر Compute Service Down باشد، مسیر بررسی با زمانی که Compute Up است ولی Instance در حالت ERROR قرار گرفته کاملاً فرق میکند.
مثلاً اگر VM وارد ERROR شده باشد:
openstack server show <INSTANCE-ID>اطلاعات این دستور میتواند سرنخ اولیه بدهد.
اما معمولاً برای Root Cause واقعی باید سراغ Logهای Nova رفت.
نکتهای که در کار عملی اهمیت دارد این است که پیام خطایی که کاربر در Horizon میبیند الزاماً Root Cause نیست.
گاهی فقط آخرین خطای یک زنجیره طولانی از Failureهاست.
Placement یکی از سرویسهایی بود که در ابتدای یادگیری OpenStack نقش آن برای من به اندازه Nova یا Neutron واضح نبود.
اما وقتی بحث Scheduling را بررسی کردم، اهمیت آن مشخص شد.
Placement اطلاعات مربوط به Resource Providerها و Inventory منابع را نگه میدارد.
CPU
Memory
و Resource Classهای مختلف میتوانند در فرآیند انتخاب Resource Provider نقش داشته باشند.
بنابراین اگر Nova Scheduler نتواند Candidate مناسبی پیدا کند، فقط نگاه کردن به میزان RAM سیستمعامل Compute Node کافی نیست.
Cloud باید آن Resource را به شکل صحیح بشناسد.
این تفاوت مهمی است.
ممکن است روی سرور واقعاً RAM آزاد وجود داشته باشد، اما از دید سیستم Scheduling وضعیت چیز دیگری باشد.
برای همین در Troubleshooting باید همیشه بین:
Physical Reality
و
OpenStack Resource View
تفاوت قائل شد.
Glance در ظاهر یکی از قابلفهمترین سرویسهای OpenStack است.
Image را Upload میکنیم و بعد Instance را از روی آن میسازیم.
مثلاً:
openstack image listاما تجربه Migration باعث شد اهمیت Propertyهای Image برایم خیلی بیشتر شود.
وقتی یک VM را از محیط دیگری وارد OpenStack میکنیم، فقط تبدیل VMDK به QCOW2 کافی نیست.
بهخصوص در Windows، نحوه معرفی Disk Controller، VirtIO Driver، Firmware و Machine Type اهمیت زیادی پیدا میکند.
ممکن است Image با موفقیت داخل Glance Upload شود ولی VM Boot نشود.
این دو موضوع نباید با هم اشتباه گرفته شوند.
Image Upload Success ≠ Guest Boot Success
در مهاجرت Windows این موضوع کاملاً خودش را نشان میدهد.
اگر Guest انتظار یک Storage Controller خاص را داشته باشد ولی در OpenStack دیسک با VirtIO-SCSI ارائه شود و Driver لازم Boot-Critical نباشد، سیستمعامل ممکن است اصلاً Boot نشود.
در چنین شرایطی مشکل از Glance نیست؛ Glance Image را درست نگه داشته است.
مشکل در سازگاری Guest با Hardware Model مقصد است.
این همان نوع مرزبندیای است که Troubleshooting OpenStack بدون آن خیلی سریع گیجکننده میشود.
برای من یکی از جذابترین و در عین حال چالشبرانگیزترین قسمتهای OpenStack شبکه بود.
اگر از محیط VMware آمده باشید، احتمالاً با vSwitch، Distributed Switch، Port Group و VLAN راحت هستید.
اما در OpenStack وارد مفاهیمی مثل:
Network
Subnet
Port
Router
Floating IP
Security Group
Provider Network
Overlay Network
میشویم.
و وقتی Backend شبکه OVN/OVS باشد، لایههای دیگری هم اضافه میشوند.
در یکی از Labها با مسئله MTU روبهرو شدم.
در ظاهر ممکن بود همهچیز درست به نظر برسد:
Instance ساخته شده بود.
Port وجود داشت.
Network وجود داشت.
OVS هم بالا بود.
اما Connectivity آن چیزی نبود که انتظار داشتم.
در شبکههای Overlay، اینجا باید به Encapsulation هم فکر کرد.
اگر Packet در مسیر داخل Tunnel قرار بگیرد، Header اضافه میشود.
بنابراین MTU شبکه Underlay و Overlay نمیتواند بدون توجه به Encapsulation انتخاب شود.
در Lab مقدار MTU را پایینتر تنظیم کردم و این موضوع یکی از مثالهای خوبی بود که نشان داد:
وجود Interface و Port به معنی سالم بودن Data Path نیست.
برای بررسی اولیه شبکه معمولاً چند سطح را جدا میکنم.
ابتدا OpenStack:
openstack network listopenstack subnet listopenstack port list
بعد OVS:
ovs-vsctl show
و بسته به سناریو، بررسی OVN و Flowها.
اگر VM IP گرفته ولی ارتباط ندارد، سؤال بعدی این نیست که «Neutron کار میکند یا نه؟»
سؤال بهتر این است:
Packet تا کجای مسیر پیش میرود؟
این تغییر نوع سؤال، Troubleshooting را بسیار سریعتر میکند.
برای یادگیری اولیه، DevStack ابزار بسیار خوبی بود.
سریع میتوانستم یک Environment ایجاد کنم و رفتار سرویسها را ببینم.
اما وقتی هدفم از صرفاً شناخت سرویسها به سمت Deployment ساختاریافتهتر رفت، Kolla-Ansible برایم جذابتر شد.
در Kolla سرویسهای OpenStack به شکل Containerized اجرا میشوند و Kolla-Ansible فرآیند Deployment و Configuration آنها را مدیریت میکند.
در تجربه All-in-One، قبل از Deploy واقعی، مرحله Precheck اهمیت زیادی داشت.
مثلاً:
kolla-ansible prechecks -i ./all-in-one
این مرحله صرفاً یک تشریفات قبل از نصب نیست.
مشکلاتی مثل Dependency، Interface Configuration و بخشی از ناسازگاریهای Environment بهتر است قبل از Deploy شناسایی شوند.
بعد:
kolla-ansible deploy -i ./all-in-one
و پس از Deployment:
kolla-ansible post-deploy
تجربه من از این مسیر باعث شد یک اصل دیگر برایم جدی شود:
هر خطای Deployment را نباید با اجرای مجدد Deploy حل کرد.
اول باید بدانیم Failure در چه Taskی رخ داده و چرا.
گاهی مشکل Package است.
گاهی Python Dependency.
گاهی Network Interface.
گاهی Image Tag.
گاهی Proxy.
گاهی Configuration.
اجرای کورکورانه مجدد Deployment ممکن است فقط همان خطا را دوباره تولید کند.
به نظرم یکی از اشتباهات رایج این است که OpenStack را با VMware به شکل Component-to-Component مقایسه کنیم.
مثلاً بگوییم:
Nova = ESXi
Horizon = vCenter
Neutron = vDS
این مقایسه برای توضیح بسیار اولیه شاید کمک کند، اما از نظر معماری دقیق نیست.
OpenStack Cloud Control Plane دارد و سرویسهای آن از طریق APIها و مکانیزمهای داخلی با یکدیگر کار میکنند.
در واقع بهتر است به جای پیدا کردن معادل هر Component، Workflow را مقایسه کنیم.
مثلاً:
در VMware یک VM چگونه Provision میشود؟
در مقابل:
در OpenStack یک Instance چگونه Provision میشود؟
این مقایسه بسیار مفیدتر است.
بعد از چند بار درگیر شدن با خطاهای مختلف، برای خودم یک روش ساده ایجاد کردم.
اول مشخص میکنم Failure در کدام Layer است.
آیا Authentication کار میکند؟
openstack token issue
آیا Endpointها درست هستند؟
openstack endpoint list
آیا Compute Serviceها سالم هستند؟
openstack compute service list
آیا Hypervisor و Resourceها دیده میشوند؟
openstack hypervisor list
آیا Image سالم و Active است؟
openstack image list
Network، Subnet و Port درست ایجاد شدهاند؟
openstack network list
openstack subnet list
openstack port list
Instance در چه State قرار دارد؟
openstack server show <INSTANCE-ID>
اگر Control Plane ظاهراً سالم است، حالا سراغ Backend میروم:
Nova Logs
Neutron Logs
OVN
OVS
libvirt
QEMU/KVM
Linux Networking
این روش همیشه Root Cause را فوراً پیدا نمیکند، ولی جلوی یک اشتباه بزرگ را میگیرد:
Troubleshooting تصادفی.
Restart کردن RabbitMQ، Nova، Neutron و Database بدون اینکه بدانیم مشکل کجاست، ممکن است حتی شرایط را بدتر کند.
اگر بخواهم تجربهام از OpenStack را در یک جمله خلاصه کنم، میگویم:
OpenStack را باید بهصورت Flow یاد گرفت، نه بهصورت لیست سرویسها.
اینکه بدانیم Keystone برای Identity است یا Nova برای Compute، فقط شروع کار است.
بخش مهمتر این است که بدانیم وقتی کاربر درخواست ایجاد یک Instance میدهد، این درخواست چگونه بین سرویسها حرکت میکند.
اگر این Flow را بفهمیم، معماری قابلدرک میشود.
وقتی معماری قابلدرک شد، Troubleshooting هم از حالت آزمون و خطا خارج میشود.
به همین دلیل اگر امروز دوباره بخواهم OpenStack را از صفر یاد بگیرم، ابتدا دهها سرویس آن را حفظ نمیکنم.
از یک Cloud کوچک شروع میکنم.
یک Image میسازم.
یک Network ایجاد میکنم.
یک Instance بالا میآورم.
و بعد دقیقاً دنبال میکنم که برای انجام همین عملیات ساده چه سرویسهایی با هم صحبت کردهاند.
از نظر من، آن نقطه شروع واقعی یادگیری OpenStack است.