در این مقاله، موضوع «وقتی vCenter بالا نمیآید» را بررسی میکنیم. یک vCenter که تا قبل از آن بدون مشکل کار میکرد، از دسترس خارج شده بود. خود Appliance روشن بود و ارتباط شبکهای هم وجود داشت، اما سرویس اصلی vCenter بالا نمیآمد.
اولین واکنش در چنین شرایطی معمولاً مشخص است: وضعیت سرویسها را ببینیم و سرویسی که Down شده دوباره Start کنیم.
اما اینجا vpxd مسئله اصلی بود و تلاش برای بالا آوردنش نتیجهای نداشت.
وقتی سرویسی یک بار Fail میشود، Restart کردن منطقی است. ولی وقتی دوباره Fail میشود، از آن لحظه به بعد Restart کردن دیگر Troubleshooting نیست. باید بفهمیم سرویس هنگام Start دقیقاً کجا متوقف میشود.
در این مورد، چیزی که مسیر عیبیابی را عوض کرد یک خط داخل Log بود:
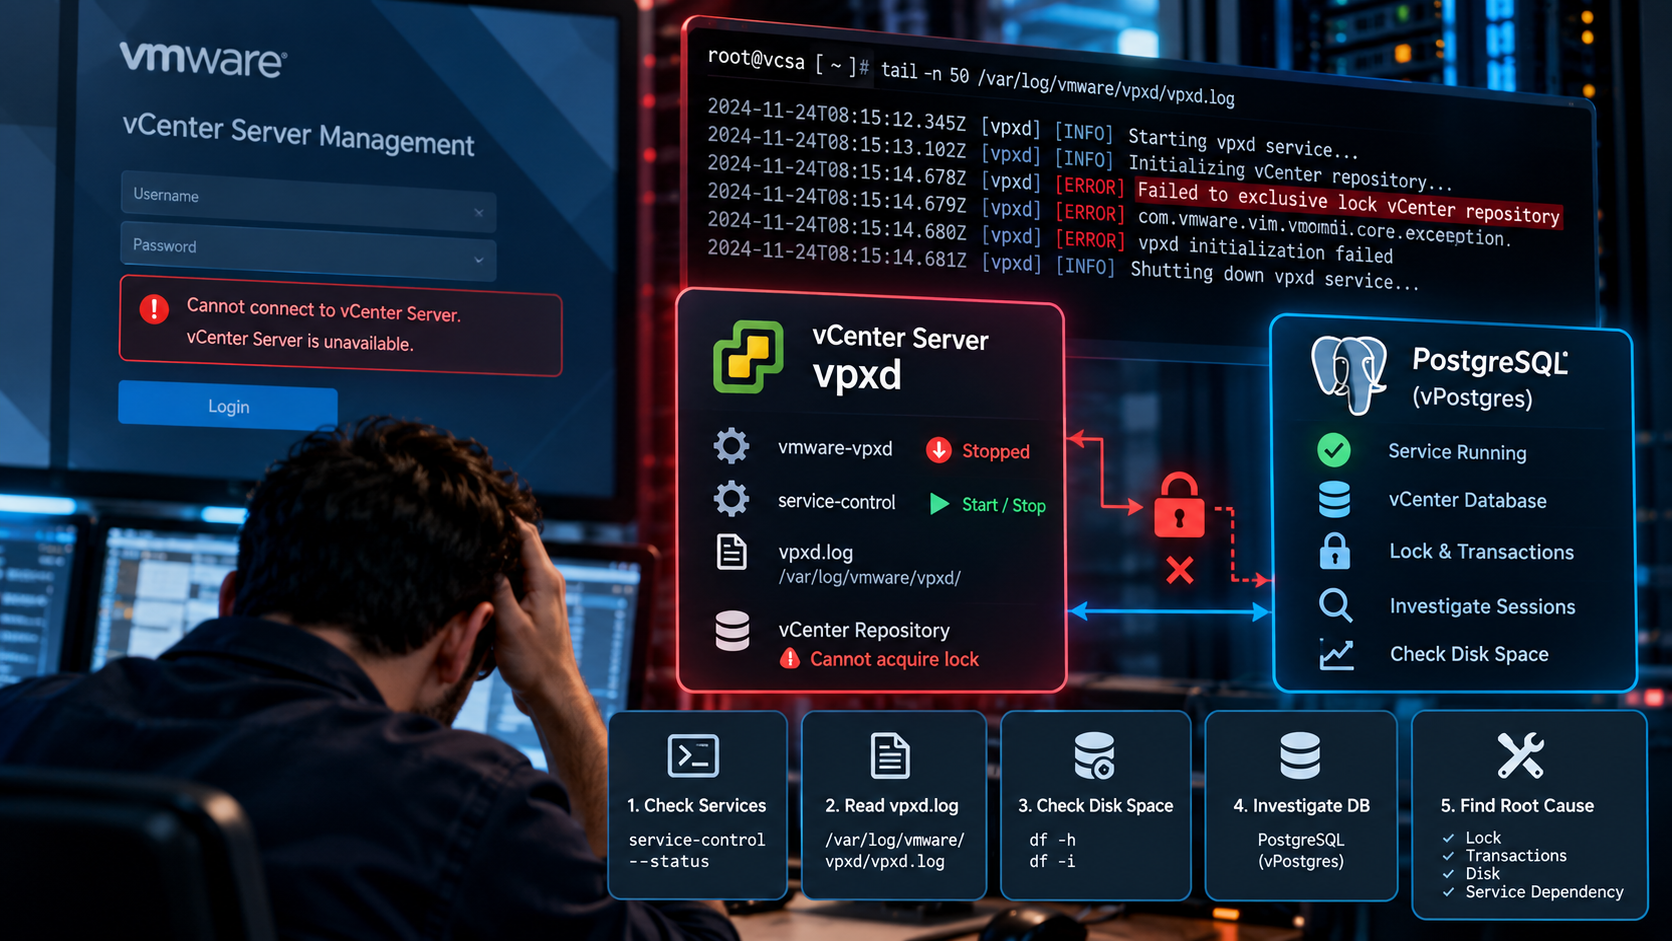
Failed to exclusive lock vCenter repository
در نگاه اول شاید شبیه یک خطای عمومی vCenter باشد، ولی همین جمله سرنخ خوبی میدهد: vpxd نمیتواند Repository خودش را آنطور که انتظار دارد در اختیار بگیرد.
از اینجا به بعد مسئله دیگر «vCenter بالا نمیآید» نبود.
مسئله تبدیل شد به:
چرا vpxd نمیتواند Repository را Lock کند؟
همین تغییر سؤال، Scope عیبیابی را خیلی کوچکتر کرد.
قبل از دست زدن به چیزی، وضعیت واقعی سرویسها را دیدم
روی VCSA میتوان وضعیت سرویسها را با service-control بررسی کرد:
service-control --status
اگر بخواهم فقط وضعیت vpxd را ببینم:
service-control --status vmware-vpxd
در چنین شرایطی فقط اینکه سرویس Stopped است برایم کافی نیست.
میخواهم بدانم سرویسهای وابسته چه وضعیتی دارند و آیا با خرابی گسترده Appliance طرف هستم یا مشکل بیشتر حول خود vCenter Server Service میچرخد.
این تفاوت مهم است.
اگر تعداد زیادی سرویس حیاتی همزمان Down باشند، مسیر بررسی با زمانی که تقریباً همهچیز بالا است و فقط vpxd Start نمیشود فرق دارد.
بعد میتوانیم Start سرویس را امتحان کنیم:
service-control --start vmware-vpxd
اگر بالا آمد و پایدار ماند، داستان متفاوت است.
ولی اگر Start شود و دوباره Fail کند، دیگر تکرار همین Command اطلاعات جدیدی به ما نمیدهد.
وقت Log است.
برای vpxd از خود vpxd.log شروع میکنم
یکی از اولین Logهایی که در چنین مشکلی سراغش میروم:
/var/log/vmware/vpxd/vpxd.log
برای دیدن آخرین اتفاقات:
tail -n 100 /var/log/vmware/vpxd/vpxd.log
یا برای دنبال کردن Log هنگام Start سرویس:
tail -f /var/log/vmware/vpxd/vpxd.log
در یک Session دیگر میتوان Start را انجام داد و دید دقیقاً قبل از Fail شدن چه اتفاقی ثبت میشود.
این روش را بیشتر از این دوست دارم که ابتدا کل Log را با grep error زیرورو کنم.
دلیلش ساده است: هر ERRORای Root Cause نیست.
ممکن است یک Failure اصلی باعث شود ده Component دیگر هم Error ثبت کنند. اگر از پایین Log شروع کنیم و Sequence اتفاقات را ببینیم، شانس بیشتری داریم اولین Failure معنیدار را پیدا کنیم.
در این Incident همان پیام مربوط به Repository مهم شد:
Failed to exclusive lock vCenter repository
اینجا دیگر مشخص بود باید ارتباط vpxd و Database را جدیتر بررسی کنم.
Repository در این خطا یعنی چه؟
vCenter فقط مجموعهای از Serviceها و یک Web UI نیست.
اطلاعات زیادی از Inventory و Configuration گرفته تا Stateهای مدیریتی در Database نگهداری میشوند.
در VCSAهای جدید، PostgreSQL داخلی یا همان vPostgres بخش مهمی از این معماری است.
پس vpxd هنگام Start باید بتواند با Database کار کند.
وقتی Log درباره گرفتن Exclusive Lock روی Repository صحبت میکند، من دیگر بدون Evidence سراغ Network، ESXi Hostها یا Restart کردن vCenter نمیروم.
تمرکز را میگذارم روی ارتباط:
vpxd
  ↓
vCenter Repository
  ↓
PostgreSQL
ولی یک نکته مهم وجود دارد:
دیدن کلمه lock به این معنی نیست که همان لحظه باید وارد Database شویم و Lockها را Kill کنیم.
اول باید ثابت کنیم واقعاً چه اتفاقی افتاده است.
اول خود PostgreSQL باید سالم باشد
قبل از اینکه دنبال Query یا Session خاص بگردم، وضعیت سرویس Database را بررسی میکنم.
در VCSA میتوان وضعیت سرویسهای مرتبط را از همان service-control دید:
service-control --status
اگر PostgreSQL خودش Down باشد، مسئله خیلی متفاوت است.
اما ممکن است Database بالا باشد و vpxd همچنان نتواند Repository را Lock کند.
این همان جایی است که عبارت معروف:
Service Running ≠ Service Healthy
دوباره خودش را نشان میدهد.
Process میتواند Running باشد، ولی از دید Application هنوز مشکلی وجود داشته باشد.
فضای دیسک را هم خیلی زود بررسی میکنم
قبل از اینکه عیبیابی Database را پیچیده کنم، یک Check ساده ولی مهم انجام میدهم:
df -h
VCSA چندین Partition و Mount Point دارد و پر شدن بعضی از آنها میتواند رفتار سرویسها را بههم بریزد.
در چنین Incidentهایی دوست ندارم بیست دقیقه دنبال PostgreSQL Lock بگردم و بعد بفهمم یکی از File Systemهای مهم 100 درصد پر شده است.
برای بررسی inode هم:
df -i
ارزش دارد.
این دو دستور Root Cause همه خرابیهای vCenter نیستند، ولی هزینه اجرای آنها تقریباً صفر است و میتوانند خیلی زود یک فرضیه مهم را رد یا تأیید کنند.
نکتهای که در این Incident مهم شد: Lock
Database برای حفظ Consistency از Lock استفاده میکند.
خود Lock چیز بدی نیست.
اتفاقاً بدون Lock، چند Transaction میتوانند همزمان State مشترکی را تغییر دهند و Database را وارد وضعیت نامعتبر کنند.
مشکل زمانی است که Application منتظر Lockی بماند که آزاد نمیشود، Session دیگری آن را نگه داشته باشد یا State قبلی باعث شده باشد Application نتواند کاری را که هنگام Startup لازم دارد انجام دهد.
در این Incident پیام:
Failed to exclusive lock vCenter repository
باعث شد بررسی از سطح Service به سطح Database برسد.
این دقیقاً همان جایی است که باید کمی محتاطتر شد.
چون از این مرحله به بعد یک Troubleshooting اشتباه میتواند از خود Incident خطرناکتر باشد.
چرا مستقیم سراغ Kill کردن Session نمیروم؟
فرض کنیم متوجه شویم یک Session یا Transaction در PostgreSQL Lock نگه داشته است.
وسوسهانگیز است که سریع آن را Terminate کنیم.
اما قبلش باید بفهمیم:
این Session متعلق به چیست؟
واقعاً Blocking ایجاد کرده؟
هنوز Active است؟
Transaction باز دارد؟
آیا Application دیگری به آن وابسته است؟
اگر بدون فهمیدن این موارد Session را Kill کنیم، ممکن است علامت مشکل را پاک کنیم ولی علت اصلی باقی بماند.
بدتر از آن، ممکن است State دیگری را خراب کنیم.
برای همین در Database Troubleshooting، مشاهده باید قبل از تغییر باشد.
اینجا تفاوت Log خواندن با Error Hunting مشخص میشود
اگر فقط عبارتهای ERROR و FAIL را از vpxd.log استخراج کنیم، احتمالاً تعداد زیادی نتیجه خواهیم داشت.
اما چیزی که من دنبال آن هستم Sequence است.
مثلاً:
vpxd starts
↓
database initialization
↓
repository access
↓
exclusive lock attempt
↓
failure
↓
service shutdown
این Sequence خیلی بیشتر از ده Error پراکنده اطلاعات میدهد.
حالا میدانیم Failure قبل از بالا آمدن کامل vpxd و در مرحله Repository Access رخ داده است.
یعنی Errorهایی که بعد از آن ثبت شدهاند ممکن است صرفاً Consequence باشند.
یکی از چیزهایی که کار با vCenter و OpenStack هر دو به من یاد دادهاند همین است:
اولین Error معنیدار معمولاً از آخرین Error مهمتر است.
آیا Restart کردن کل VCSA مشکل را حل میکند؟
ممکن است.
ولی «ممکن است درست شود» با «مشکل را پیدا کردم» فرق دارد.
اگر مشکل مربوط به یک State موقت باشد، Reboot ممکن است آن State را پاک کند و vCenter دوباره بالا بیاید.
اما بعد از آن چه میدانیم؟
تقریباً هیچ.
اگر چند هفته بعد دوباره اتفاق بیفتد، همان نقطه اول هستیم.
برای همین اگر شرایط عملیاتی اجازه بدهد، قبل از Reboot حداقل این موارد را جمع میکنم:
وضعیت Serviceها
آخرین vpxd.log
وضعیت Disk
وضعیت PostgreSQL
زمان شروع Incident
اولین Error مرتبط
حتی اگر در نهایت مجبور به Restart شویم، Evidence را از دست ندادهایم.
چرا ESXiها همچنان کار میکنند وقتی vCenter Down است؟
این موضوع مخصوصاً برای کسی که اولین بار با خرابی vCenter روبهرو میشود مهم است.
Down شدن vCenter به این معنی نیست که تمام VMها روی ESXi خاموش میشوند.
vCenter Management Plane است.
ESXi Hostها همچنان Hypervisor هستند و VMهای Running معمولاً به کارشان ادامه میدهند.
یعنی ممکن است:
vCenter → Down
ESXi → Running
VMs → Running
Applications → Running
باشد.
این موضوع در Incident Response خیلی مهم است.
اگر Workloadها سالماند، نباید با عجله اقداماتی انجام دهیم که Impact حادثه را بیشتر کند.
اول مشخص میکنیم چه چیزی واقعاً Down است.
Management Plane؟
یا Workload Plane هم تحت تأثیر قرار گرفته؟
این دو Incident یکسان نیستند.
از ESXi مستقیم استفاده کنیم؟
در زمان Down بودن vCenter، بسته به شرایط میتوان مستقیماً به ESXi Hostها دسترسی مدیریتی داشت.
ولی اینجا هم باید محتاط بود.
هدف این نیست که چون vCenter Down است، شروع کنیم به تغییرات گسترده روی Hostها.
اگر VMها سالماند، بهتر است Scope تغییرات را محدود نگه داریم و اول خود vCenter را برگردانیم.
در Incident واقعی، هر تغییر اضافی یک متغیر جدید وارد مسئله میکند.
و هرچه متغیرهای بیشتری تغییر کنیم، فهمیدن Root Cause سختتر میشود.
وقتی سرویس دوباره بالا آمد، کار تمام نشده
فرض کنیم مشکل Repository برطرف شد و:
service-control --start vmware-vpxd
این بار موفق بود.
من فقط به پیام:
Successfully started service vmware-vpxd
اکتفا نمیکنم.
دوباره وضعیت را میبینم:
service-control --status vmware-vpxd
بعد vpxd.log را بررسی میکنم تا ببینم Error قبلی تکرار شده یا نه.
بعد Client را تست میکنم.
Inventory را بررسی میکنم.
Hostها Connected هستند؟
VMها درست نمایش داده میشوند؟
Taskهای مدیریتی اجرا میشوند؟
یعنی Verification باید End-to-End باشد.
سرویس بالا آمده، ولی باید مطمئن شویم vCenter واقعاً به وضعیت عملیاتی برگشته است.
یک نکتهای که این خرابی برای من پررنگ کرد
اگر فقط از بیرون نگاه کنیم، Incident خیلی ساده تعریف میشود:
vCenter Down شده بود.
ولی این تعریف برای Troubleshooting تقریباً بیاستفاده است.
بعد از چند دقیقه بررسی، تعریف دقیقتر شد:
VCSA روشن است ولی vpxd Start نمیشود.
بعد:
vpxd هنگام Startup Fail میشود.
و بعد از Log:
vpxd هنگام دسترسی به Repository نمیتواند Exclusive Lock موردنیاز را بگیرد.
ببینید چقدر Scope کوچک شد.
از:
VMware خراب است
رسیدیم به:
vpxd
 ↓
Startup
 ↓
Repository Access
 ↓
Database Lock
برای من بخش مهم Incident همین است.
Troubleshooting خوب الزاماً یعنی بلد بودن صد Command نیست.
بیشتر یعنی بتوانیم یک مشکل بزرگ و مبهم را آنقدر کوچک کنیم تا به یک سؤال مشخص برسیم.
اگر دوباره با همین مشکل روبهرو شوم
این بار مسیرم تقریباً مشخص است.
اول Impact را میسنجم.
آیا فقط vCenter Down است یا Workloadها هم مشکل دارند؟
بعد وضعیت سرویسها:
service-control --status
بعد وضعیت vpxd.
اگر Start نمیشود، بهجای تکرار Restart سراغ:
/var/log/vmware/vpxd/vpxd.log
میروم.
همزمان Checkهای کمهزینهای مثل:
df -h
df -i
را انجام میدهم.
بعد Sequence خطا را پیدا میکنم.
اگر شواهد دوباره من را به Repository/PostgreSQL برسانند، تازه Database را وارد Investigation میکنم.
نه زودتر.
و اگر قرار باشد تغییری در Database انجام شود، قبل از آن باید بدانم دقیقاً چه Session یا Lockی را تغییر میدهم و چرا.
این ترتیب شاید چند دقیقه بیشتر از Restart کردن کورکورانه زمان ببرد، ولی در عوض بعد از Incident میدانیم واقعاً چه اتفاقی افتاده است.
چیزی که از این Incident برایم ماند
مهمترین نکته برای من خود خطای Failed to exclusive lock vCenter repository نبود.
چیزی که بیشتر ماند روش رسیدن به آن بود.
در شروع Incident فقط میدانستم vCenter بالا نمیآید.
اگر همانجا شروع به Restart کردن Database، vCenter، ESXi یا Appliance میکردم، شاید سرویس برمیگشت؛ شاید هم نه.
ولی حتی در صورت موفقیت، دلیل خرابی همچنان ناشناخته باقی میماند.
بهجای آن سعی کردم هر مرحله فقط یک سؤال را جواب بدهم:
VCSA در دسترس است؟
کدام سرویس Down است؟
آیا vpxd Start میشود؟
اگر نه، در چه مرحلهای Fail میشود؟
Log چه میگوید؟
اولین Error معنیدار چیست؟
این Error به کدام Component اشاره میکند؟
و فقط بعد از آن وارد Component بعدی شدم.
برای من این Incident نمونه خوبی بود از اینکه در زیرساخت، خیلی وقتها مهمترین ابزار Troubleshooting یک Command خاص نیست.
مهمتر از آن این است که قبل از اجرای Command بعدی بدانیم دقیقاً دنبال جواب چه سؤالی هستیم
مطالب مرتبط