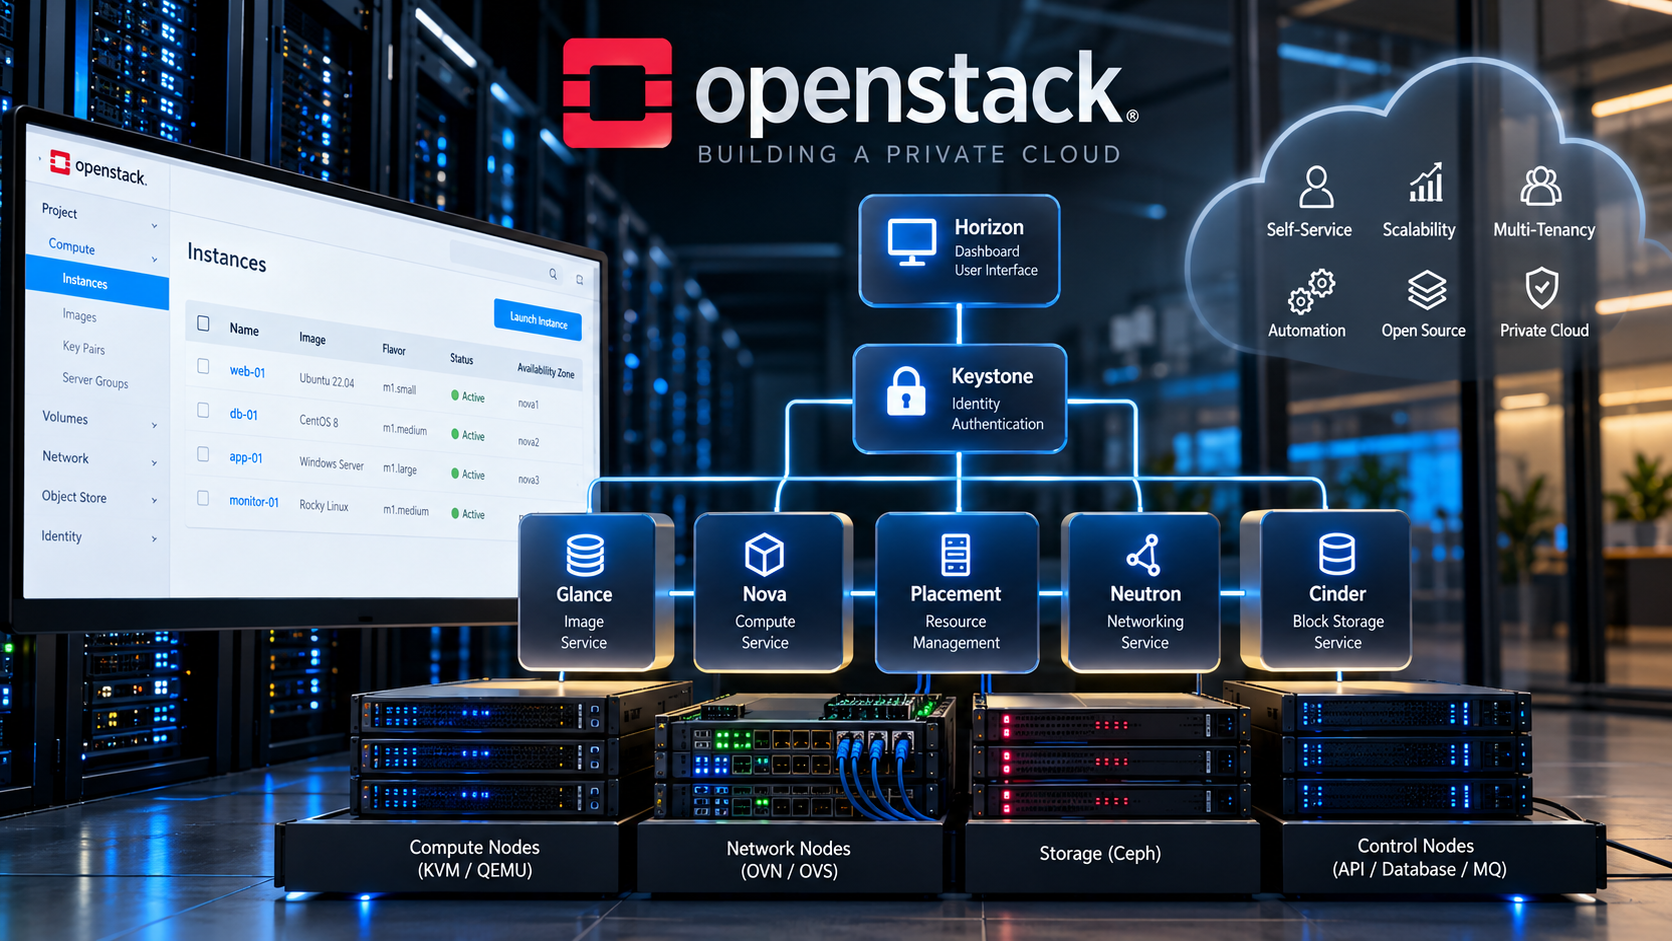
در این مقاله، موضوع «OVN در OpenStack» را بررسی میکنیم. یکی از دردسرهای شبکه OpenStack این است که گاهی از سمت Neutron همهچیز درست به نظر میرسد، ولی ارتباط ماشین مجازی همچنان مشکل دارد.
Instance ساخته شده، IP گرفته، Port در Neutron وجود دارد و حتی وضعیت Resourceها هم در نگاه اول عادی است. با این حال ممکن است دو ماشین روی دو Compute مختلف همدیگر را نبینند، دسترسی به شبکه بیرونی برقرار نشود یا ارتباط به شکلی عجیب فقط برای بعضی Packetها کار کند.
من اوایل در چنین شرایطی بیشتر بین Neutron و Open vSwitch دنبال مشکل میگشتم. Port را با OpenStack CLI بررسی میکردم، بعد روی Node سراغ OVS میرفتم و سعی میکردم از روی Bridgeها و Interfaceها بفهمم چه اتفاقی افتاده است.
مشکل این روش این بود که یک قسمت مهم وسط این دو را نادیده میگرفتم: OVN.
در محیطی که Neutron با ML2/OVN پیاده شده، Portی که در Neutron میبینیم قرار نیست مستقیم و بدون واسطه تبدیل به Flow روی OVS شود. بین چیزی که در Control Plane تعریف کردهایم و چیزی که در نهایت Packet را روی Compute جابهجا میکند، چند مرحله وجود دارد.
وقتی این مسیر را شناختم، عیبیابی شبکه هم برایم منطقیتر شد.
بهجای اینکه از بین دهها دستور OVN و OVS یکی را امتحان کنم، سعی میکنم یک Resource مشخص ــ معمولاً همان Port ماشین مشکلدار ــ را بردارم و ببینم تا کجای مسیر درست پیش رفته است.
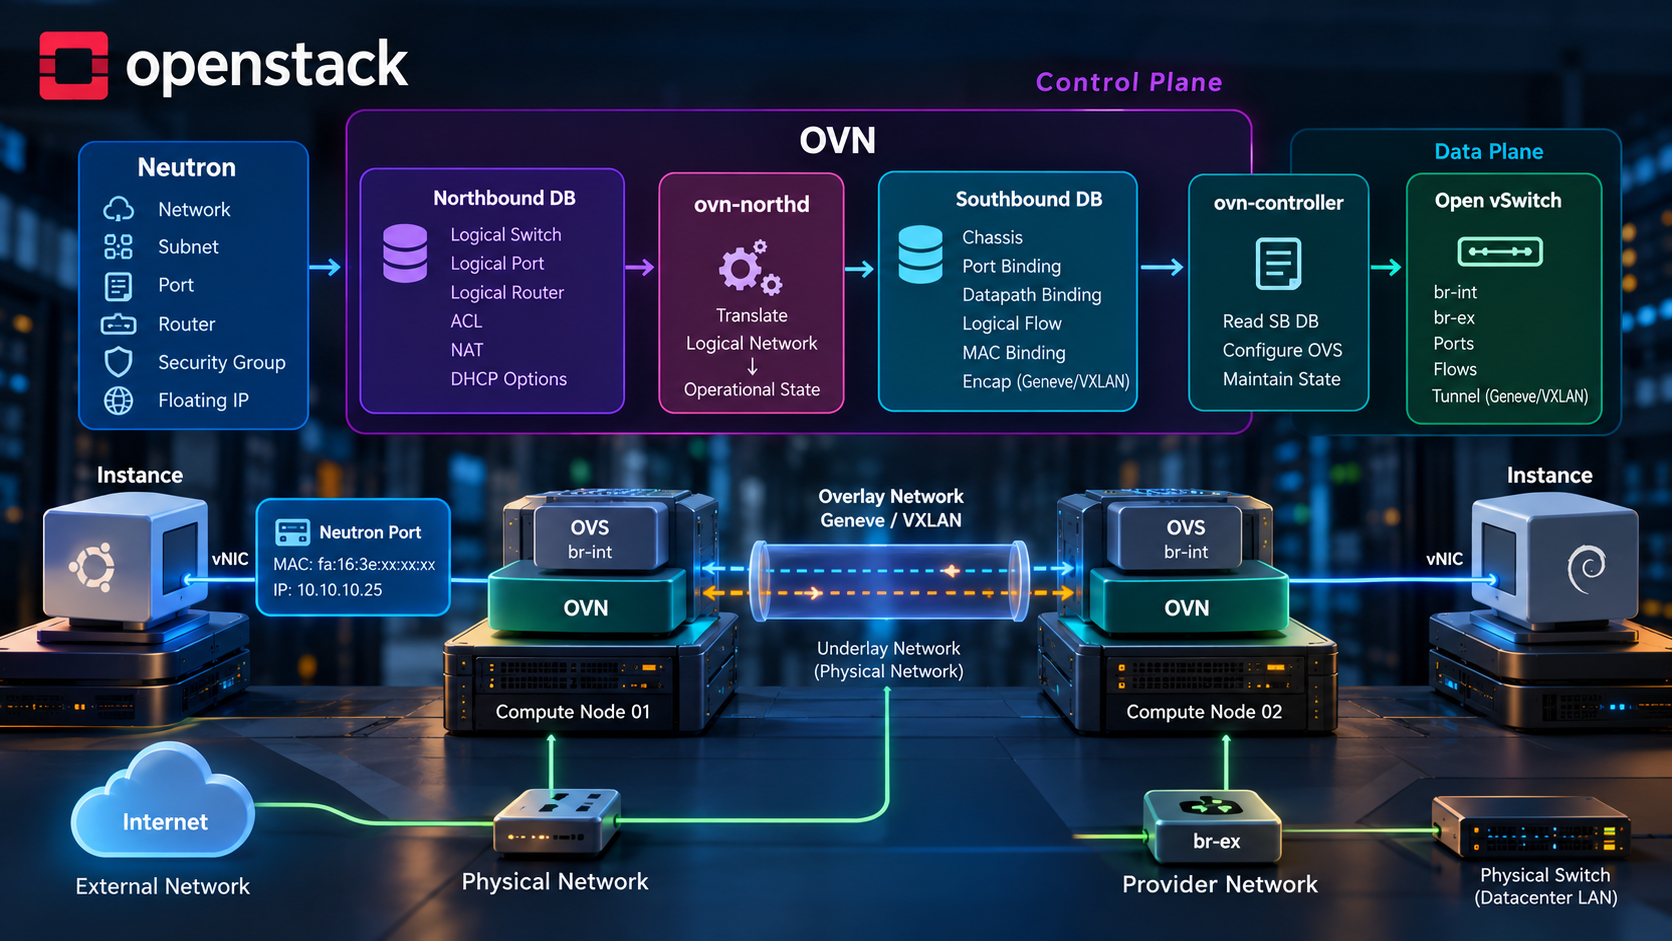
مسیر کلی چیزی شبیه این است:
Neutron
   ↓
OVN Northbound Database
   ↓
ovn-northd
   ↓
OVN Southbound Database
   ↓
ovn-controller
   ↓
Open vSwitch
   ↓
Packet
این دیاگرام برای من بیشتر از اینکه یک دیاگرام معماری باشد، نقشه Troubleshooting است.
اول باید تکلیف OVN و OVS را روشن کنیم
اسم OVN و OVS آنقدر کنار هم دیده میشود که اوایل خیلی راحت میشود این دو را یک چیز در نظر گرفت.
ولی نقششان متفاوت است.
Open vSwitch یا OVS همان بخشی است که به Data Plane نزدیک است. Bridge، Port، Interface و Flow دارد و در نهایت Packet روی آن پردازش میشود.
OVN یک لایه بالاتر قرار میگیرد.
در OVN با مفاهیمی مثل Logical Switch، Logical Router، Logical Switch Port، ACL، NAT و DHCP سروکار داریم. یعنی بهجای اینکه برای هر Network و Router مستقیماً Flowهای OVS را خودمان مدیریت کنیم، یک مدل منطقی از شبکه داریم و OVN این مدل را به چیزی تبدیل میکند که روی Nodeها قابل اجرا باشد.
اگر بخواهم خیلی خلاصه نگاه کنم:
Neutron میگوید چه شبکهای میخواهیم.
OVN آن شبکه را مدل و توزیع میکند.
OVS در نهایت Packet را جابهجا میکند.
همین تفکیک ساده در زمان عیبیابی خیلی کمک میکند.
مثلاً اگر Logical Port اصلاً در OVN ایجاد نشده باشد، بررسی Flowهای OVS هنوز زود است.
از یک Port واقعی شروع کنیم
فرض کنیم یک Instance به نام web01 داریم و شبکه آن درست کار نمیکند.
من معمولاً اول سراغ خود Neutron میروم:
openstack port list --server web01
یا اگر ID ماشین را دارم:
openstack port list --server <INSTANCE-ID>
اینجا دنبال Port ID، Fixed IP، MAC Address و Status میگردم.
بعد Port را دقیقتر میبینم:
openstack port show <PORT-ID>
فرض کنیم Neutron میگوید Port وجود دارد و IP هم به آن اختصاص داده شده است.
مثلاً:
MAC Address : fa:16:3e:xx:xx:xx
Fixed IP    : 10.10.10.25
Status      : ACTIVE
این اطلاعات مفیدند، اما هنوز فقط State از دید Neutron را میبینیم.
سؤال بعدی من این است:
آیا OVN هم همین Port را میشناسد؟
اینجاست که Northbound Database وارد ماجرا میشود.
Northbound Database را مثل نسخه منطقی شبکه میبینم
در OVN یک Northbound Database داریم که State منطقی شبکه در آن قرار میگیرد.
مثلاً:
Logical_Switch
Logical_Switch_Port
Logical_Router
Logical_Router_Port
ACL
NAT
DHCP_Options
اگر در OpenStack یک Network ایجاد کنیم، انتظار داریم Representation منطقی آن در OVN هم وجود داشته باشد.
همین موضوع درباره Port صادق است.
برای دیدن Logical Switch Portها میتوانیم از:
ovn-nbctl list Logical_Switch_Port
استفاده کنیم.
ولی اجرای این دستور و خواندن صدها Port روش خوبی برای Troubleshooting نیست.
Port IDای که از Neutron پیدا کردیم اینجا به درد میخورد.
مثلاً:
ovn-nbctl find Logical_Switch_Port \
external_ids:neutron:port_name=<PORT-ID>
بسته به نسخه و نحوه ثبت External IDها ممکن است شکل دقیق جستوجو متفاوت باشد؛ بنابراین قبل از اینکه روی یک Key خاص حساب کنم، معمولاً خود Recordهای مربوط را هم نگاه میکنم.
موضوع اصلی Command نیست.
موضوع این است که همان Port را از Neutron وارد OVN کنیم.
اگر Port در Neutron وجود داشته باشد ولی Logical Switch Port متناظر آن در Northbound پیدا نشود، دیگر لازم نیست فعلاً دنبال MTU، Tunnel یا Physical Switch بگردیم.
مشکل خیلی بالاتر از این حرفهاست.
State مورد انتظار هنوز به OVN نرسیده است.
اینجا UUID از اسم VM مفیدتر میشود
در Horizon اسم ماشین مثلاً web01 است و برای ما کاملاً قابل فهم است.
اما وقتی وارد Backend میشویم، UUIDها اهمیت بیشتری پیدا میکنند.
Network یک UUID دارد.
Port یک UUID دارد.
Router یک UUID دارد.
در OVN هم معمولاً همین شناسهها کمک میکنند Objectهای متناظر را پیدا کنیم.
برای همین هنگام عیبیابی شبکه سعی میکنم از همان اول این اطلاعات را کنار هم داشته باشم:
Instance ID
Network ID
Subnet ID
Port ID
Fixed IP
MAC Address
Compute Host
این کار ساده بعداً جلوی مقدار زیادی جستوجوی بیهدف را میگیرد.
پس ovn-northd وسط این ماجرا چه کار میکند؟
تا اینجا Northbound میداند چه Logical Networkای باید داشته باشیم.
ولی Compute Node برای Forward کردن Packet به اطلاعات عملیاتیتری نیاز دارد.
ovn-northd همین وسط قرار میگیرد.
Northbound State را میخواند و آن را به State موردنیاز Southbound تبدیل میکند.
یعنی:
Logical Network Intent
        ↓
     ovn-northd
        ↓
Operational Network State
اگر Network و Port در Northbound درست باشند ولی اطلاعات مورد انتظار در Southbound شکل نگرفته باشند، آن وقت دیگر بررسی ovn-northd منطقی میشود.
این دقیقاً همان چیزی است که منظورم از Troubleshooting مرحلهای است.
من از اول ovn-northd را Restart نمیکنم.
اول باید دلیلی داشته باشم که شک کنم مشکل بین Northbound و Southbound است.
Southbound جایی است که داستان به Nodeهای واقعی نزدیک میشود
Southbound Database نسبت به Northbound به اجرای واقعی شبکه نزدیکتر است.
اینجا با Objectهایی مثل:
Chassis
Encap
Port_Binding
Datapath_Binding
Logical_Flow
MAC_Binding
مواجه میشویم.
مثلاً:
ovn-sbctl show
یک دید کلی از Chassisها و Port Bindingها میدهد.
یا:
ovn-sbctl list Chassis
کمک میکند ببینیم OVN چه Nodeهایی را بهعنوان Chassis میشناسد.
این قسمت برای من خیلی مهم است، چون ممکن است از دید OpenStack یک Compute کاملاً Up باشد ولی داستان شبکه چیز دیگری بگوید.
مثلاً:
openstack compute service list
نشان دهد nova-compute روی compute02 بالا است.
این فقط درباره Nova اطلاعات میدهد.
هنوز ثابت نمیکند compute02 از دید OVN هم وضعیت درستی دارد.
Chassis دقیقاً همان جایی است که Compute وارد OVN میشود
روی Nodeهایی که در Data Plane OVN شرکت میکنند، ovn-controller اجرا میشود و Node خودش را در Southbound Database معرفی میکند.
در نتیجه Chassis داریم.
اگر VM روی compute02 قرار گرفته باشد، یکی از چیزهایی که میخواهم بدانم این است که آیا OVN این Chassis را درست میشناسد یا نه.
مثلاً:
ovn-sbctl list Chassis
اطلاعاتی درباره Chassisها و Encapsulation Endpointها میدهد.
اگر Compute موردنظر اینجا وجود نداشته باشد، دیگر اینکه Port در Neutron ACTIVE دیده میشود برایم کافی نیست.
حالا یک اختلاف State داریم که ارزش بررسی دارد.
Tunnel Endpoint را هم باید جدی گرفت
وقتی دو VM روی دو Compute متفاوت هستند، Packet باید somehow بین این دو Host منتقل شود.
در شبکه Overlay این کار از طریق Encapsulation انجام میشود.
بسته به طراحی میتوانیم Geneve یا تکنولوژی Overlay مربوطه را داشته باشیم.
مثلاً:
VM1
 |
Compute01
 |
Overlay Tunnel
 |
Underlay Network
 |
Compute02
 |
VM2
OVN باید بداند Tunnel Endpoint هر Chassis چیست.
اگر IP مربوط به Encapsulation اشتباه باشد یا Underlay بین Nodeها Connectivity نداشته باشد، Network منطقی هرچقدر هم درست باشد Packet به مقصد نمیرسد.
برای همین وقتی میبینم دو VM روی یک Compute با هم ارتباط دارند ولی به محض اینکه روی Computeهای جدا قرار میگیرند ارتباط قطع میشود، موضوع برایم خیلی معنیدار میشود.
در چنین شرایطی دیگر اولین مظنون من Security Group نیست.
Cross-Compute Path را جدیتر بررسی میکنم:
Chassis
Encapsulation
Underlay Connectivity
Tunnel
MTU
Firewall
این نوع مقایسه معمولاً خیلی سریعتر از نگاه کردن به همهچیز بهصورت همزمان ما را به مشکل نزدیک میکند.
Port Binding یکی از جاهایی است که ارزش وقت گذاشتن دارد
در Southbound، Port_Binding نشان میدهد Logical Portها چطور به محیط اجرایی متصل شدهاند.
میتوانیم بررسی کنیم:
ovn-sbctl list Port_Binding
ولی باز هم ترجیح میدهم Port مشخص خودم را دنبال کنم، نه کل Database را.
چیزی که میخواهم بفهمم این است:
Port ماشین من به Chassis مورد انتظار Bind شده یا نه؟
اگر VM روی compute02 است ولی Port Binding آن چیزی غیر از انتظار نشان میدهد، حالا یک سرنخ واقعی داریم.
این خیلی بهتر از این است که صرفاً بگوییم «OVN مشکل دارد».
ovn-controller همان قسمتی است که Southbound را به OVS نزدیک میکند
روی هر Chassis، ovn-controller اطلاعات Southbound را میخواند و با OVS همان Node کار میکند.
اینجا تقریباً به Data Plane رسیدهایم.
مسیر تا اینجا:
Neutron Port
     ↓
Logical Switch Port
     ↓
Northbound DB
     ↓
ovn-northd
     ↓
Southbound DB
     ↓
Port Binding / Chassis
     ↓
ovn-controller
     ↓
OVS
اگر تمام Stateهای بالاتر درست باشند ولی چیزی که روی OVS انتظار داریم ایجاد نشده باشد، آن وقت بررسی ovn-controller معنی پیدا میکند.
یعنی Log آن را با یک سؤال مشخص میخوانیم:
چرا State موجود در Southbound روی این Chassis اعمال نشده است؟
این خیلی فرق دارد با اینکه Log را باز کنیم و دنبال هر چیزی که کلمه error دارد بگردیم.
حالا ovs-vsctl show معنی بیشتری پیدا میکند
در ابتدای Troubleshooting هم میتوانستم این دستور را اجرا کنم:
ovs-vsctl show
اما آن موقع دقیقاً نمیدانستم دنبال چه چیزی هستم.
حالا اطلاعات بیشتری دارم.
میدانم VM روی کدام Compute است.
Port ID را دارم.
MAC را دارم.
Chassis را بررسی کردهام.
Port Binding را دیدهام.
حالا OVS را نگاه میکنم.
در Deploymentهای OVN معمولاً Bridge Integration یا همان br-int بخش مهمی از Data Plane است.
مثلاً:
ovs-vsctl list-br
و:
ovs-vsctl show
میتوانند Structure موجود را نشان دهند.
در این مرحله اگر Interface مورد انتظار وجود نداشته باشد، معنی آن با زمانی که هنوز نمیدانستیم Port اصلاً در OVN وجود دارد یا نه کاملاً متفاوت است.
Bridge Mapping؛ جایی که External Network میتواند بیسروصدا خراب شود
Internal Traffic و External Traffic را نباید یکی در نظر گرفت.
ممکن است دو VM داخل Cloud کاملاً با هم ارتباط داشته باشند ولی دسترسی به Provider Network خراب باشد.
در این حالت Bridge Mapping اهمیت پیدا میکند.
در OVS میتوان External IDهای مربوط به Mapping را بررسی کرد:
ovs-vsctl get Open_vSwitch . external_ids:ovn-bridge-mappings
ممکن است چیزی شبیه این ببینیم:
physnet1:br-ex
یعنی Physical Network منطقی physnet1 به br-ex Map شده است.
اگر Provider Network در Neutron به physnet1 اشاره کند ولی Mapping روی Node اشتباه باشد، مشکل در جایی ایجاد میشود که از داخل Horizon بهراحتی دیده نمیشود.
این یکی از دلایلی است که در راهاندازی Kolla-Ansible انتخاب neutron_external_interface برایم مهم شد.
آن تنظیم صرفاً اسم یک NIC نیست؛ بخشی از مسیری است که Cloud را به شبکه فیزیکی وصل میکند.
مشکل MTU باعث شد بیشتر به Packet Path اعتماد کنم تا Statusها
یکی از مشکلاتی که در Lab خودم با آن درگیر شدم MTU بود.
شبکه Overlay داشتیم و برای رسیدن به وضعیت پایدارتر MTU را روی 1400 تنظیم کردم.
چیزی که این مشکل را جالب میکرد این بود که شبکه الزاماً کاملاً Down نبود.
این بدترین نوع مشکل شبکه است.
وقتی همهچیز Down است، حداقل میدانیم یک جای جدی خراب است.
ولی MTU میتواند شرایطی ایجاد کند که:
Ping کوچک → OK
Packet بزرگتر → Fail
بعضی Connectionها → OK
بعضی Transferها → مشکل
اگر فقط Statusهای Neutron و OVN را نگاه کنیم، ممکن است همهچیز سالم باشد.
Port وجود دارد.
Chassis وجود دارد.
Binding درست است.
OVS هم Interface را دارد.
ولی Packet هنوز مشکل دارد.
اینجاست که باید از Control Plane فاصله بگیریم و خود Packet را بررسی کنیم.
چرا Overlay به MTU حساس است؟
فرض کنیم Underlay ما MTU برابر 1500 دارد.
Packet Tenant قرار است از Compute01 به Compute02 برود.
برای عبور از Overlay باید Encapsulate شود.
یعنی Header جدیدی به Packet اضافه میشود.
به شکل ساده:
Original VM Packet
        ↓
Overlay Encapsulation
        ↓
Larger Packet
        ↓
Physical Network
اگر برای این Overhead فضای کافی در نظر گرفته نشده باشد، Packet میتواند Fragment یا Drop شود.
به همین دلیل در شبکه Overlay فقط MTU داخل Guest مهم نیست.
باید کل Path را ببینیم:
Guest
 ↓
Virtual NIC
 ↓
OVS
 ↓
Tunnel
 ↓
Physical NIC
 ↓
Switch
 ↓
Physical NIC
 ↓
Tunnel
 ↓
OVS
 ↓
Guest
یک MTU نامناسب در این مسیر میتواند رفتارهایی ایجاد کند که در نگاه اول هیچ شباهتی به «قطع شبکه» ندارند.
برای MTU فقط Ping معمولی کافی نیست
اگر:
ping <DESTINATION>
جواب دهد، هنوز MTU را رد نمیکنم.
در Linux میتوان Packet بزرگتر را با Don't Fragment آزمایش کرد:
ping -M do -s 1472 <DESTINATION>
عدد 1472 برای همه محیطها نسخه جادویی نیست؛ هدف این است که Maximum Payload قابل عبور در Path را پیدا کنیم.
اندازه را کم میکنیم تا مشخص شود چه Packet Sizeای بدون Fragment عبور میکند.
بعد MTU Interfaceها را هم میبینیم:
ip link
اگر ارتباط کوچک کار میکند ولی با افزایش Packet Size قطع میشود، دیگر یک سرنخ خیلی بهتر از «شبکه بعضی وقتها مشکل دارد» داریم.
وقتی Statusها جواب نمیدهند، tcpdump هنوز یکی از بهترین ابزارهاست
هرچقدر SDN پیچیدهتر شود، در نهایت Packet همان Packet است.
برای همین وقتی Stateها درستاند ولی ارتباط نداریم، tcpdump برایم خیلی ارزشمند میشود.
مثلاً:
tcpdump -ni <INTERFACE> icmp
فرض کنیم از VM1 به VM2 Ping میکنم.
اگر Packet را روی یک نقطه میبینم و روی نقطه بعدی نمیبینم، Boundary مشکل را پیدا کردهام.
این روش خیلی قابل اعتمادتر از این است که پنج Component را Restart کنیم و ببینیم اتفاقی مشکل برطرف میشود یا نه.
گاهی یک Capture ساده بیشتر از صدها خط Log اطلاعات میدهد.
Logical Flow را چه زمانی بررسی میکنم؟
OVN Policyهای منطقی را به Logical Flow تبدیل میکند.
برای دیدن آنها:
ovn-sbctl lflow-list
اما این دستور خروجی زیادی تولید میکند.
من معمولاً بدون دلیل سراغ آن نمیروم.
اگر مسئله نشان دهد Network Objectها، Binding و Chassis درستاند ولی Forwarding یا Policy رفتاری غیرمنتظره دارد، آن وقت Logical Flow ارزش بررسی پیدا میکند.
مثلاً ممکن است بخواهم Flowهای مربوط به یک Datapath مشخص را ببینم.
نکته اینجاست که هرچه پایینتر میرویم، حجم اطلاعات بیشتر میشود.
پس قبل از رفتن به لایه پایین باید Scope مشکل را کوچک کرده باشیم.
ovn-trace؛ ابزاری که وقتی معماری را بفهمیم تازه ارزشش مشخص میشود
یکی از ابزارهای خیلی مفید OVN برای تحلیل Logical Packet Path، ovn-trace است.
این ابزار میتواند نشان دهد یک Packet فرضی در Pipeline منطقی OVN چه مسیری طی میکند و کدام Ruleها روی آن اعمال میشوند.
اما ovn-trace هم چیزی نیست که صرفاً Command آن را حفظ کنیم.
برای استفاده مفید باید حداقل بدانیم:
Logical Switch چیست.
Logical Port مبدأ کدام است.
MAC و IP مبدأ و مقصد چیست.
Datapath موردنظر کدام است.
بعد میتوانیم یک Packet مشخص را در مدل منطقی OVN دنبال کنیم.
این ابزار بهخصوص زمانی ارزش دارد که Configuration از نظر ظاهری درست است ولی میخواهیم بفهمیم OVN فکر میکند با Packet چه باید بکند.
یک نکته مهم: ovn-trace جای tcpdump را نمیگیرد
این دو ابزار دو سؤال متفاوت را جواب میدهند.
ovn-trace میتواند Logical Pipeline را تحلیل کند.
tcpdump به من میگوید Packet واقعی در یک Interface دیده شده یا نه.
ممکن است Logical Pipeline کاملاً درست باشد ولی Underlay فیزیکی مشکل داشته باشد.
برعکس، ممکن است Physical Connectivity عالی باشد ولی یک ACL منطقی Packet را Drop کند.
برای همین در Troubleshooting جدی این دو دید را کنار هم میگذارم:
What SHOULD happen?
        ↓
    ovn-trace

What DID happen?
        ↓
     tcpdump
این تفاوت برای من خیلی مهم است.
یک سناریوی واقعیتر: VMهای یک Compute ارتباط دارند، Cross-Compute نه
فرض کنیم سه VM داریم:
VM1 → compute01
VM2 → compute01
VM3 → compute02
VM1 و VM2 همدیگر را Ping میکنند.
VM1 و VM3 نه.
این اطلاعات بهتنهایی خیلی ارزش دارند.
میدانیم Local Connectivity روی compute01 حداقل تا حدی کار میکند.
Portهای VM1 و VM2 احتمالاً مشکل بنیادی ندارند.
حالا روی مسیر بین Chassisها تمرکز میکنم.
اول میبینم VM3 واقعاً روی چه Hostی قرار دارد:
openstack server show VM3
Port:
openstack port list --server VM3
بعد Chassis:
ovn-sbctl list Chassis
Encapsulation IPها را بررسی میکنم.
Connectivity Underlay بین دو Node را تست میکنم.
MTU را بررسی میکنم.
Firewall بین Tunnel Endpointها را فراموش نمیکنم.
بعد اگر لازم باشد Capture میگیرم.
این خیلی منطقیتر از بررسی مجدد DHCP ماشین VM1 است، چون شواهد فعلی ما را به سمت Cross-Compute Path بردهاند.
یک سناریوی دیگر: Internal Network کار میکند ولی Floating IP نه
اینجا هم اطلاعات خوبی داریم.
اگر VM به Gateway داخلی دسترسی دارد و VMهای داخل Network را میبیند، بخش زیادی از مسیر داخلی سالم است.
حالا بیشتر روی این موارد تمرکز میکنم:
Logical Router
NAT
External Port
Gateway Chassis
Provider Network
Bridge Mapping
br-ex
Physical NIC
Physical Switch
Upstream Gateway
این همان جایی است که External Network دیگر فقط موضوع OVN نیست.
بخشی از مشکل میتواند بیرون OpenStack باشد.
مثلاً Bridge Mapping داخل OpenStack درست است، ولی VLAN روی Switch Port اجازه عبور ندارد.
اگر فقط داخل OVN بگردیم، هیچوقت آن مشکل را پیدا نمیکنیم.
گاهی مشکل اصلاً OVN نیست
این جمله را عمداً میگویم چون وقتی یک تکنولوژی پیچیده باشد، خیلی راحت تبدیل به متهم همیشگی میشود.
VM شبکه ندارد؟
OVN.
Floating IP کار نمیکند؟
OVN.
دو VM Ping ندارند؟
OVN.
ولی در عمل مشکل ممکن است خیلی سادهتر باشد.
Security Group.
Guest Firewall.
Route داخل سیستمعامل.
DNS.
Driver کارت شبکه.
Physical VLAN.
MTU.
Upstream Firewall.
برای همین قبل از رفتن به عمق Southbound Database، همیشه سعی میکنم Failure را دقیق تعریف کنم.
مثلاً جمله:
«شبکه VM خراب است»
تقریباً هیچ اطلاعاتی ندارد.
ولی این جمله:
«VM روی compute02 از طریق Fixed IP به VM روی compute01 دسترسی ندارد، ولی دو VM روی compute01 با همان Security Group با هم ارتباط دارند»
یک نقطه شروع عالی برای Troubleshooting است.
روشی که الان برای عیبیابی OVN استفاده میکنم
برای خودم این مسیر بهتر از یک Checklist بلند جواب داده است.
از Resource خراب شروع میکنم.
مثلاً یک Port.
اول Neutron:
openstack port show <PORT-ID>
بعد بررسی میکنم Representation منطقی آن در Northbound وجود دارد یا نه.
بعد Southbound و Port Binding.
بعد Chassis.
بعد ovn-controller.
بعد OVS.
اگر همه اینها درست باشند، دیگر بیشتر روی Packet Path تمرکز میکنم:
Logical Flow
Tunnel
MTU
Physical Network
Security Policy
یعنی مسیر Investigation تقریباً برعکس مسیر ساخت State است:
ساخت شبکه:
Neutron
↓
Northbound
↓
Southbound
↓
ovn-controller
↓
OVS
Troubleshooting:
Port مشکلدار
↓
Neutron State؟
↓
Northbound State؟
↓
Southbound Binding؟
↓
Chassis؟
↓
OVS؟
↓
Packet واقعاً عبور میکند؟
این روش باعث شده کمتر بین Commandهای مختلف سرگردان شوم.
چیزی که در نهایت از OVN برایم مهم شد
فهم OVN برای من از جایی شروع نشد که اسم Tableهای Northbound و Southbound را حفظ کردم.
اتفاقاً حفظ کردن آنها بهتنهایی خیلی کمک نمیکرد.
چیزی که واقعاً مفید بود این بود که بفهمم بین یک Port در Neutron و Packetی که روی کارت شبکه فیزیکی حرکت میکند، چه اتفاقی میافتد.
وقتی این مسیر را بشناسیم، خیلی از خطاهای عجیب شبکه قابل تقسیم شدن میشوند.
Port در Neutron نیست؟
هنوز در لایه OpenStack هستیم.
Port در Neutron هست ولی در Northbound نیست؟
بین Neutron و OVN دنبال مشکل میگردیم.
Northbound درست است ولی Binding مشکل دارد؟
Southbound و Chassis مهم میشوند.
همه Stateها درستاند ولی Packet عبور نمیکند؟
دیگر باید Data Plane، Flow، Tunnel، MTU و Physical Network را ببینیم.
در Lab خودم هم مشکل MTU دقیقاً یادآوری خوبی بود که سالم بودن Control Plane به معنی سالم بودن Packet Path نیست.
از آن به بعد در عیبیابی شبکه OpenStack سعی میکنم کمتر بپرسم:
«کدام سرویس خراب است؟»
و بیشتر بپرسم:
«آخرین جایی که State یا Packet هنوز درست بود کجا بود؟»
برای من، این سؤال کاربردیترین راه برای فهم و عیبیابی OVN بوده است.