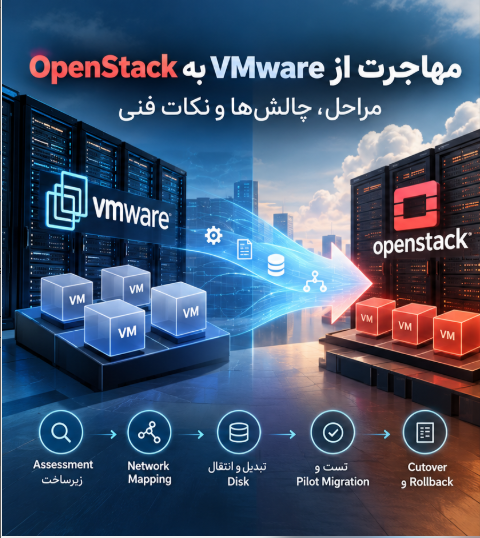
مهاجرت از VMware به OpenStack؛ مراحل، چالشها و نکات فنی
مهاجرت از VMware به OpenStack صرفاً به معنی کپی کردن فایل یک ماشین مجازی از یک Hypervisor به Hypervisor دیگر نیست. در یک پروژه واقعی، علاوه بر Disk ماشین مجازی باید وضعیت سیستمعامل، نوع Firmware، درایورهای Storage و Network، ساختار شبکه، وابستگیهای سرویس، Downtime قابل قبول و روش بازگشت به وضعیت قبل بررسی شوند.
مهاجرت از VMware به OpenStack صرفاً به معنی کپی کردن فایل یک ماشین مجازی از یک Hypervisor به Hypervisor دیگر نیست. در یک پروژه واقعی، علاوه بر Disk ماشین مجازی باید وضعیت سیستمعامل، نوع Firmware، درایورهای Storage و Network، ساختار شبکه، وابستگیهای سرویس، Downtime قابل قبول و روش بازگشت به وضعیت قبل بررسی شوند.
به همین دلیل، قبل از شروع انتقال VMها باید مشخص باشد چه Workloadهایی قرار است منتقل شوند، مقصد OpenStack چه معماریای دارد و هر ماشین در مقصد با چه مشخصاتی اجرا خواهد شد.
اگر سازمان هنوز در مرحله طراحی مقصد قرار دارد، ابتدا باید معماری Compute، Network و Storage مشخص شود. در این مرحله استفاده از خدمات [مشاوره و معماری زیرساخت](/services/infrastructure-consulting) میتواند قبل از شروع Migration، وابستگیهای فنی پروژه را مشخص کند.
مرحله اول؛ Assessment زیرساخت VMware
اولین مرحله، تهیه Inventory از محیط مبدأ است.
برای هر VM حداقل اطلاعات زیر باید جمعآوری شود:
- سیستمعامل و Version
- تعداد vCPU
- مقدار RAM
- تعداد و ظرفیت Diskها
- نوع Disk Controller
- BIOS یا UEFI
- تعداد Network Adapterها
- VLAN و Network Mapping
- IP Address
- وابستگی به سرویسهای دیگر
- Snapshotهای موجود
- VMware Tools
- میزان فضای مصرفشده
- Downtime قابل قبول
این اطلاعات مشخص میکنند که آیا VM مستقیماً قابل انتقال است یا قبل از Migration نیاز به تغییر دارد.
برای مثال، یک Windows VM که در VMware از Controller متفاوتی استفاده میکند ممکن است پس از انتقال Disk به OpenStack نتواند از VirtIO-SCSI بوت شود؛ مگر اینکه Driver موردنیاز قبل از اولین Boot در سیستمعامل آماده شده باشد.
مرحله دوم؛ بررسی مقصد OpenStack
قبل از انتقال اولین ماشین، باید مشخص شود VM در OpenStack چگونه اجرا خواهد شد.
در OpenStack چند سرویس مستقیماً در این فرایند نقش دارند. Nova مسئول Compute است، Neutron شبکه را مدیریت میکند و Glance برای مدیریت Imageها استفاده میشود.
Glance امکان Import و نگهداری Imageهایی را فراهم میکند که بعداً توسط سرویسهای دیگر OpenStack از جمله Nova مصرف میشوند. مستندات رسمی Glance نیز روشهای مختلف Import از جمله glance-direct را تعریف میکنند. OpenStack Docs
در این مرحله مواردی مانند Flavor، Network، Security Group، Image Properties و Storage Backend باید از قبل مشخص باشند.
برای محیطهایی که هنوز OpenStack مقصد آنها طراحی یا پیادهسازی نشده است، صفحه [OpenStack و Private Cloud](/services/openstack-private-cloud) جزئیات حوزه این سرویس را ارائه میکند.
مرحله سوم؛ Network Mapping
یکی از قسمتهایی که در Migration نباید به انتهای پروژه موکول شود Network است.
فرض کنیم VM مبدأ به VLAN 120 متصل است. در مقصد باید مشخص شود این شبکه به چه Network یا Subnet در Neutron نگاشت خواهد شد.
صرفاً ساختن یک Network با نام مشابه کافی نیست.
باید مواردی مانند Gateway، Routing، DNS، MTU، Security Group، Floating IP و دسترسی VM به سرویسهای دیگر بررسی شوند.
در پروژههای بزرگ بهتر است یک Mapping مشخص تهیه شود:
VMware Port Group
        ↓
Source VLAN
        ↓
OpenStack Network
        ↓
Subnet
        ↓
Router / External Network
به این ترتیب هنگام انتقال تعداد زیادی VM، Network Mapping به تصمیم موردی برای هر ماشین تبدیل نمیشود.
مرحله چهارم؛ Export و تبدیل Disk
در VMware معمولاً Disk ماشینها به صورت VMDK هستند، در حالی که در OpenStack بسته به Storage Backend و معماری مقصد میتوان از فرمتهایی مانند QCOW2 یا RAW استفاده کرد.
بنابراین یکی از مراحل Migration میتواند تبدیل Disk باشد.
اما تبدیل Format بهتنهایی تضمین نمیکند که سیستمعامل در مقصد Boot شود.
برای مثال باید Partition Table، Bootloader، Firmware، Controller و Driverهای Boot-Critical نیز بررسی شوند.
در Windows این موضوع اهمیت بیشتری پیدا میکند؛ زیرا اگر سیستمعامل Driver مربوط به Controller مقصد را نداشته باشد، Disk ممکن است سالم باشد اما Windows قادر به Boot نباشد.
مرحله پنجم؛ آمادهسازی VirtIO
در محیطهای KVM/QEMU معمولاً VirtIO برای ارائه I/O مناسب به VM استفاده میشود.
برای Windows VMها بهتر است Driverهای موردنیاز قبل از Cutover بررسی شوند؛ بهخصوص:
VirtIO SCSI
VirtIO Network
Balloon
RNGمهمترین بخش در Migration معمولاً Storage Driver است، چون نبود Driver مناسب میتواند مستقیماً مانع Boot سیستمعامل شود.
در نتیجه تست Boot باید بخشی از Pilot باشد، نه اینکه اولین بار هنگام Cutover اصلی انجام شود.
مرحله ششم؛ Pilot Migration
قبل از انتقال تعداد زیادی ماشین، یک یا چند VM نماینده انتخاب میشوند.
Pilot باید فقط روشن شدن VM را بررسی نکند.
حداقل موارد زیر باید Validate شوند:
Boot
Disk
Network
DNS
Application
Service dependencies
Performance
Time synchronization
Security rules
Monitoring
Backup
اگر VM روشن شود اما Application به Database دسترسی نداشته باشد، Migration هنوز موفق محسوب نمیشود.
جزئیات این حوزه در صفحه [خدمات مهاجرت زیرساخت](/services/infrastructure-migration) نیز تشریح شده است.
مرحله هفتم؛ Cutover
پس از موفقیت Pilot میتوان Workloadها را در Migration Waveهای مشخص دستهبندی کرد.
برای هر Wave باید حداقل این موارد وجود داشته باشند:
Source VM
Target specification
Migration window
Expected downtime
Responsible team
Validation checklist
Rollback condition
در Cold Migration معمولاً VM خاموش میشود، داده نهایی منتقل میشود و سپس ماشین در مقصد راهاندازی میشود. مفهوم Cold Migration در خود Nova نیز به مهاجرتی گفته میشود که Instance خاموش شده، منتقل و دوباره راهاندازی میشود؛ هرچند این قابلیت Nova مربوط به جابهجایی Instance در محیط Compute خود OpenStack است و نباید آن را با VMware-to-OpenStack Migration یکی دانست. OpenStack Docs
Rollback را قبل از Migration مشخص کنید
Rollback نباید زمانی طراحی شود که Migration شکست خورده است.
قبل از Cutover باید مشخص باشد:
- در چه شرایطی Rollback انجام میشود؟
- VM مبدأ تا چه زمانی نگهداری میشود؟
- تغییرات DNS چگونه برگردانده میشوند؟
- اگر Data در مقصد تغییر کرد چه اتفاقی میافتد؟
- حداکثر زمان مجاز برای Troubleshooting چقدر است؟
وجود این موارد باعث میشود تصمیم بازگشت بر اساس معیار فنی انجام شود، نه فشار زمانی هنگام اختلال.
جمعبندی
مهاجرت VMware به OpenStack مجموعهای از مراحل مرتبط است: Assessment، طراحی مقصد، Network Mapping، آمادهسازی سیستمعامل، Export و Conversion، Import، Pilot، Validation، Cutover و Rollback.
در محیط Production بهتر است ابتدا تعداد محدودی Workload بهعنوان Pilot انتخاب شوند و پس از مشخص شدن مشکلات واقعی، Migration Waveهای بعدی انجام شوند.
برای بررسی سناریوی عملی مهاجرت میتوانید جزئیات [خدمات مهاجرت زیرساخت ابرپلاس](/services/infrastructure-migration) را مشاهده کنید.
مقاله دوم — معماری Ceph
عنوان:
Ceph چیست؟ آشنایی با معماری Ceph و اجزای اصلی آن
Slug:
ceph-architecture-guideCategory: Ceph & Storage
Focus Keyword:
معماری CephSEO Title:
Ceph چیست؟ معماری Ceph، OSD، MON، MGR، PG و CRUSHMeta Description:
معماری Ceph را به زبان فنی بررسی میکنیم؛ نقش OSD، MON، MGR، Pool، Placement Group و CRUSH و نحوه توزیع و بازیابی داده در Ceph.Canonical:
https://abrplus.net/ceph/ceph-architecture-guideAlt تصویر شاخص:
معماری Ceph و ارتباط MON MGR OSD PG و CRUSHمتن مقاله
Ceph چیست؟ آشنایی با معماری Ceph و اجزای اصلی آنCeph یک Distributed Storage System است که برای ذخیرهسازی داده روی مجموعهای از Server و Disk طراحی شده است. برخلاف معماریهایی که Storage به یک Controller مرکزی وابسته است، Ceph داده را بین تعدادی OSD توزیع میکند و برای تعیین محل قرارگیری داده از الگوریتم CRUSH استفاده میکند.
Ceph میتواند در سناریوهای مختلف Block، Object و File Storage مورد استفاده قرار گیرد و به همین دلیل در بسیاری از زیرساختهای Private Cloud نیز دیده میشود.
برای درک Ceph، بهتر است قبل از نصب Cluster ابتدا بدانیم اجزای آن چه نقشی دارند و وقتی یک Client دادهای مینویسد چه اتفاقی در Cluster رخ میدهد.
OSD چیست؟
OSD مخفف Object Storage Daemon است و یکی از اصلیترین اجزای Ceph Storage Cluster محسوب میشود.
به شکل ساده، OSD مسئول نگهداری Data و مشارکت در عملیاتهایی مانند Replication، Recovery، Rebalancing و Scrubbing است.
در یک Cluster ممکن است تعداد زیادی OSD وجود داشته باشد.
برای مثال:
Server01
 ├── OSD.0
 ├── OSD.1
 └── OSD.2

Server02
 ├── OSD.3
 ├── OSD.4
 └── OSD.5

Server03
 ├── OSD.6
 ├── OSD.7
 └── OSD.8
در این مثال سه Storage Node و ۹ OSD داریم.
اما Ceph قرار نیست هر Object را مستقیماً و به شکل ثابت به یک OSD متصل کند. برای این کار لایههای دیگری مانند Pool، PG و CRUSH وارد معماری میشوند.
MON چه کاری انجام میدهد؟
MON یا Ceph Monitor وضعیت کلی Cluster را نگهداری میکند.
Monitorها اطلاعات مربوط به Cluster Map را در اختیار دارند. این Mapها شامل اطلاعاتی درباره Monitorها، OSDها، Placement Groupها و CRUSH topology هستند. مستندات Ceph توضیح میدهند که Monitorها نسخه اصلی Cluster Map و وضعیت اعضای Cluster را نگهداری میکنند. Ceph Documentation
برای Production معمولاً طراحی Monitorها باید به شکلی انجام شود که خرابی یک Node باعث از دست رفتن Quorum نشود.
MON محل اصلی ذخیره Data کاربران نیست؛ نقش آن بیشتر در حفظ وضعیت و هماهنگی Cluster است.
MGR چیست؟
Ceph Manager یا MGR اطلاعات Runtime و مدیریتی Cluster را در اختیار ابزارها و Moduleهای مدیریتی قرار میدهد.
بخشهایی مانند Dashboard و تعدادی از Moduleهای مدیریتی Ceph به Manager وابستهاند.
در طراحی Production معمولاً بیش از یک Manager در نظر گرفته میشود تا در صورت از دست رفتن Manager فعال، نمونه Standby بتواند جای آن را بگیرد.
بنابراین MON و MGR را نباید با OSD اشتباه گرفت؛ OSD مستقیماً در Storage Data نقش دارد، در حالی که MON و MGR مسئولیتهای کنترلی و مدیریتی متفاوتی دارند.
Pool چیست؟
در Ceph، Pool یک لایه منطقی برای سازماندهی Objectهاست.
هر Pool تنظیمات خودش را دارد؛ از جمله سیاست Placement و نحوه محافظت از داده.
CRUSH Rule یکی از تنظیمات مهم Pool است و تعیین میکند Placement Groupها و Replicaها یا Erasure Coding Shardها چگونه در Cluster قرار بگیرند. Ceph Documentation
برای مثال میتوان Poolهای مختلفی برای Workloadهای متفاوت ایجاد کرد، اما تعداد Pool و PGها باید با معماری Cluster هماهنگ باشد.
Placement Group یا PG چیست؟
یکی از مفاهیمی که معمولاً در ابتدای یادگیری Ceph کمی مبهم است PG است.
Ceph برای هر Object مستقیماً یک OSD ثابت تعریف نمیکند.
مسیر سادهشده به این شکل است:
Object
  ↓
Pool
  ↓
Placement Group
  ↓
CRUSH
  ↓
OSDs
هر Object به یک PG نگاشت میشود و سپس CRUSH مشخص میکند آن PG باید روی کدام OSDها قرار بگیرد.
مستندات Ceph نیز توضیح میدهند که CRUSH بهصورت پویا PGها را به OSDها Map میکند. این لایه واسط باعث میشود هنگام تغییر Topology، اضافه شدن OSD یا خرابی تجهیزات، Ceph بتواند دادهها را مجدداً توزیع کند. Ceph Documentation
تعداد PGها نیز بیاهمیت نیست؛ تعداد بسیار زیاد PG میتواند مصرف Memory، CPU و Network را افزایش دهد. Ceph Documentation
CRUSH چه کاری انجام میدهد؟
CRUSH یکی از مهمترین قسمتهای معماری Ceph است.
وظیفه آن تعیین محل قرارگیری Data بر اساس Topology و Ruleهای تعریفشده است.
برای مثال یک Topology میتواند چنین ساختاری داشته باشد:
Datacenter
   ↓
Rack
   ↓
Host
   ↓
OSD
اگر Failure Domain روی host تعریف شود، Ceph میتواند Replicaهای یک PG را روی Hostهای متفاوت قرار دهد.
در محیطهای بزرگتر میتوان Rack یا سایر سطوح فیزیکی را نیز وارد CRUSH hierarchy کرد. مستندات رسمی Ceph نیز Failure Domainهایی مانند device، host، rack، row و room را در CRUSH Map توضیح میدهند. Ceph Documentation
بنابراین طراحی CRUSH Map مستقیماً با Failure Scenarioهای زیرساخت ارتباط دارد.
هنگام Write چه اتفاقی میافتد؟
فرض کنیم Client قصد ذخیره یک Object را دارد.
فرایند سادهشده به شکل زیر است:
Client
  ↓
Object
  ↓
Pool
  ↓
PG
  ↓
CRUSH
  ↓
Primary OSD
  ↓
Replica OSDs
Client با استفاده از Cluster Map میتواند محل مورد انتظار Object را محاسبه کند و با Primary OSD ارتباط بگیرد. سپس Primary OSD عملیات لازم برای Replicaها را انجام میدهد. این معماری نیاز به یک Lookup مرکزی برای پیدا کردن محل تکتک Objectها را کاهش میدهد. Ceph Documentation
اگر یک OSD خراب شود چه میشود؟
فرض کنیم Pool سه Replica دارد و یکی از OSDهایی که بخشی از PG را نگهداری میکند از دسترس خارج شود.
Ceph وضعیت را تشخیص میدهد و بر اساس وضعیت Cluster و Policyهای تعریفشده برای بازیابی تعداد Replicaهای موردنیاز اقدام میکند.
این عملیات میتواند شامل Recovery و انتقال داده بین OSDها باشد.
به همین دلیل Network در Ceph اهمیت زیادی دارد؛ مخصوصاً هنگام Recovery یا Backfill حجم قابل توجهی از Data ممکن است بین Nodeها جابهجا شود.
مستندات Ceph امکان استفاده از Network مجزا برای ترافیک داخلی Cluster مانند Replication، Heartbeat، Backfill و Recovery را نیز توضیح میدهند. Ceph Documentation
Ceph فقط اضافه کردن Disk نیست
در طراحی Production باید علاوه بر Raw Capacity موارد دیگری هم محاسبه شوند:
- تعداد Storage Nodeها
- تعداد و نوع Diskها
- Replication یا Erasure Coding
- Failure Domain
- Public/Cluster Network
- ظرفیت Usable
- Recovery Performance
- تعداد Pool و PG
- رشد آینده
- Monitoring
- Backup Strategy
- Failure Scenario
برای مثال داشتن ظرفیت Raw بالا لزوماً به معنی داشتن همان مقدار ظرفیت Usable نیست؛ سیاست محافظت از داده مستقیماً روی ظرفیت قابل استفاده اثر دارد.
برای طراحی یا بررسی چنین زیرساختی میتوانید صفحه [Ceph & Storage ابرپلاس](/services/ceph-storage) را مشاهده کنید.
جمعبندی
برای فهم معماری Ceph باید رابطه بین اجزای آن را درک کنیم:
MON → Cluster State
MGR → Management
OSD → Data Storage
Pool → Logical Data Organization
PG → Object Grouping
CRUSH → Data Placement
وقتی این ارتباط مشخص شود، مفاهیمی مثل Replication، Recovery، Rebalancing و Failure Domain نیز قابل فهمتر میشوند.
در مقالههای بعدی میتوانیم وارد بخش عملی شویم و طراحی یک Ceph Cluster واقعی را از مرحله Sizing، انتخاب Disk، Network Design و محاسبه Raw/Usable Capacity بررسی کنیم.