Ceph چیست
sfsdfdf
مطالعه مقاله ←Ceph یک پلتفرم ذخیرهسازی توزیعشده است که Block، Object و File Storage را ارائه میدهد. در این مقاله معماری Ceph، نقش MON، MGR، OSD، Pool، PG و CRUSH و مسیر ذخیره و بازیابی داده را بررسی میکنیم.
وقتی درباره زیرساختهای ابری و ذخیرهسازی توزیعشده صحبت میکنیم، Ceph یکی از نامهایی است که زیاد با آن روبهرو میشویم. مخصوصاً در معماریهایی که OpenStack در آنها استفاده میشود، Ceph یکی از گزینههای اصلی برای پیادهسازی Storage محسوب میشود.
اما Ceph صرفاً یک نرمافزار برای ذخیره فایل نیست.
Ceph یک پلتفرم Distributed Storage است؛ یعنی دادهها بهجای اینکه به یک Storage Controller یا یک دستگاه مرکزی وابسته باشند، بین چندین Storage Node و Disk توزیع میشوند.
این معماری باعث میشود بتوانیم با اضافهکردن Node و Disk جدید، ظرفیت و توان پردازشی Storage را افزایش دهیم و در عین حال برای خرابی Disk یا حتی یک Storage Node نیز طراحی مناسبی داشته باشیم.
یکی دیگر از ویژگیهای مهم Ceph این است که یک Cluster میتواند سه مدل اصلی Storage را ارائه کند:
برای درک درست Ceph باید اجزای اصلی معماری آن را بشناسیم. مهمترین مفاهیمی که در این مقاله بررسی میکنیم شامل OSD، MON، MGR، MDS، Pool، Placement Group و CRUSH هستند.
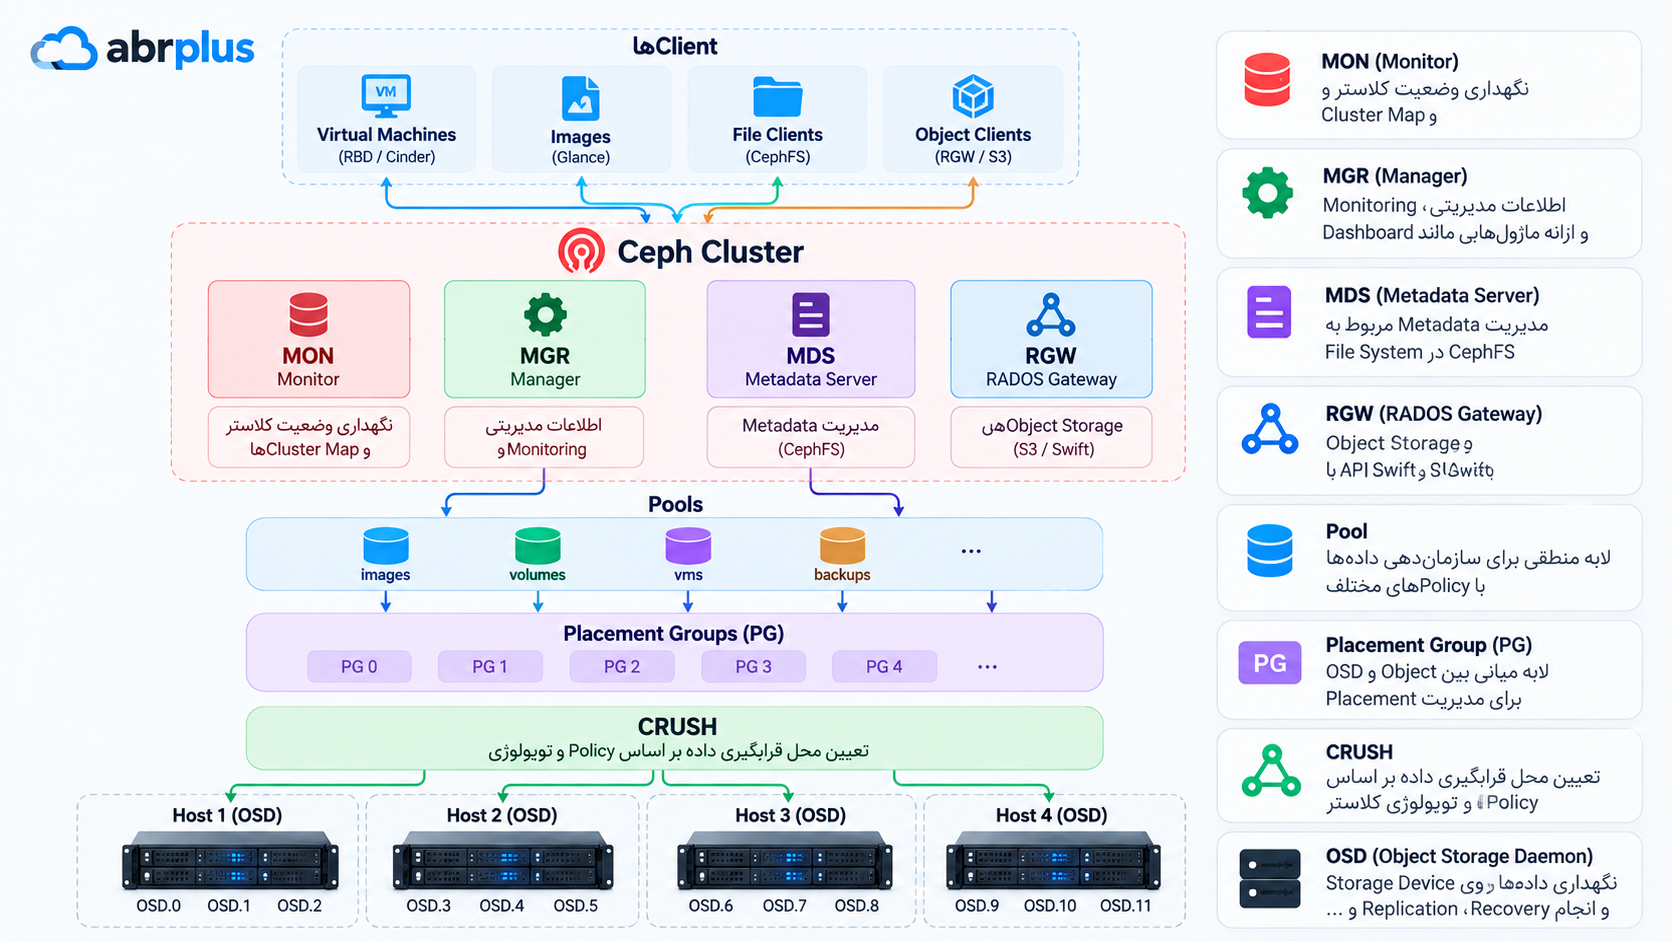
در یک Ceph Cluster چند سرویس مختلف در کنار یکدیگر فعالیت میکنند. هر سرویس مسئولیت مشخصی دارد.
بهصورت کلی میتوانیم اجزای مهم Ceph را اینطور در نظر بگیریم:
OSD مسئول نگهداری داده است.
MON وضعیت و Mapهای کلاستر را نگهداری میکند.
MGR اطلاعات مدیریتی و Monitoring را فراهم میکند.
MDS در CephFS مسئول Metadata مربوط به File System است.
Pool دادهها را بهصورت منطقی سازماندهی میکند.
PG یا Placement Group یک لایه میانی برای مدیریت Placement داده است.
و در نهایت CRUSH مشخص میکند داده بر اساس Policy و توپولوژی Cluster روی کدام OSDها قرار بگیرد.
نکته مهم این است که همه این اجزا داده کاربر را ذخیره نمیکنند. برای مثال MON وظیفه ذخیره Virtual Disk ماشینهای مجازی را ندارد. داده اصلی در نهایت توسط OSDها نگهداری میشود.
OSD مخفف Object Storage Daemon است و یکی از مهمترین اجزای Ceph محسوب میشود.
در نهایت دادههایی که وارد Ceph میشوند توسط OSDها روی Storage Deviceها نگهداری خواهند شد.
هر OSD معمولاً یک Storage Device مانند HDD، SSD یا NVMe را مدیریت میکند.
برای مثال فرض کنیم چهار Storage Server داریم و روی هر Server شش Disk برای Ceph در نظر گرفتهایم.
در این حالت میتوانیم مجموعاً ۲۴ OSD داشته باشیم:
4 Storage Node × 6 Disk = 24 OSD
البته وظیفه OSD فقط نوشتن اطلاعات روی Disk نیست.
OSDها در عملیات دیگری مانند موارد زیر نیز نقش دارند:
برای مثال اگر یکی از OSDها خراب شود، Ceph میتواند با استفاده از نسخههای سالم داده روی OSDهای دیگر، Redundancy موردنیاز را دوباره ایجاد کند.
به همین دلیل در Ceph خرابشدن یک Disk الزاماً به معنی از دست رفتن اطلاعات نیست.
MON مخفف Monitor است.
وظیفه MON نگهداری وضعیت معتبر Cluster است. Ceph برای شناخت وضعیت فعلی زیرساخت از مجموعهای از Mapها استفاده میکند.
از جمله:
برای مثال OSD Map اطلاعات مربوط به وضعیت OSDهای Cluster را در اختیار Ceph قرار میدهد.
نکته مهم این است که MON محل ذخیره اصلی داده کاربران نیست.
گاهی در شروع یادگیری Ceph این تصور ایجاد میشود که چون Monitor یکی از سرویسهای اصلی Cluster است، Client برای هر عملیات Read یا Write باید از Monitor عبور کند؛ اما معماری Ceph به این شکل نیست.
Monitor بیشتر در Control Plane کلاستر نقش دارد و اطلاعات موردنیاز درباره وضعیت Cluster را فراهم میکند.
در محیط Production معمولاً چند MON راهاندازی میشود تا Quorum تشکیل شود.
برای مثال:
MON01
MON02
MON03
در چنین معماریای، از دسترس خارج شدن یک Monitor لزوماً باعث از کار افتادن Cluster نمیشود، زیرا دو Monitor دیگر هنوز میتوانند اکثریت یا Majority را تشکیل دهند.
به همین دلیل معمولاً تعداد فردی از Monitorها، مانند ۳ یا ۵، استفاده میشود.
MGR مخفف Manager است.
Ceph Manager اطلاعات Runtime مربوط به Cluster را جمعآوری کرده و امکانات مدیریتی و Monitoring مختلفی را فراهم میکند.
برخی Moduleهای مدیریتی Ceph نیز از طریق MGR ارائه میشوند.
برای مثال:
اگر با Dashboard تحت وب Ceph کار کرده باشید، بخشی از اطلاعاتی که در Dashboard مشاهده میکنید از طریق Manager فراهم میشود.
در محیط Production معمولاً بیشتر از یک Manager داریم.
یکی Active است و دیگری میتواند در حالت Standby قرار داشته باشد.
در صورت بروز مشکل برای MGR فعال، نمونه Standby میتواند جایگزین آن شود.
MDS مخفف Metadata Server است.
اما یک نکته مهم وجود دارد:
MDS برای تمام سرویسهای Ceph الزامی نیست.
MDS عمدتاً برای CephFS مورد استفاده قرار میگیرد.
CephFS یک Distributed File System است و MDS اطلاعات Metadata مربوط به File System را مدیریت میکند.
برای مثال:
بنابراین اگر در معماری فقط از RBD برای Block Storage استفاده کنیم، MDS همان نقشی را که در CephFS دارد برای RBD ندارد.
Pool یک لایه منطقی برای سازماندهی دادهها در Ceph است.
میتوانیم برای Workloadهای مختلف Poolهای متفاوتی داشته باشیم.
مثلاً در یک زیرساخت OpenStack ممکن است Poolهایی مانند این داشته باشیم:
images
volumes
vms
backups
برای مثال Pool با نام images میتواند برای Imageهای Glance و Pool با نام volumes برای Volumeهای Cinder استفاده شود.
در سطح Pool تنظیمات مهمی وجود دارد.
از جمله:
بنابراین Pool فقط یک Folder یا Container ساده نیست. Policy مربوط به نحوه نگهداری داده نیز میتواند در سطح Pool تعریف شود.
یکی از مفاهیمی که در ابتدای یادگیری Ceph ممکن است کمی گیجکننده باشد، Placement Group یا PG است.
فرض کنیم میلیاردها Object داخل Ceph داریم.
اگر Ceph بخواهد Placement تکتک Objectها را مستقیماً در سطح OSD مدیریت کند، مدیریت این حجم از Metadata بسیار پیچیده خواهد شد.
برای حل این مسئله، Ceph از یک لایه میانی به نام Placement Group استفاده میکند.
مدل سادهشده مسیر داده به این شکل است:
Object
  ↓
Pool
  ↓
Placement Group
  ↓
CRUSH
  ↓
OSD
Object ابتدا به یک PG نگاشت میشود.
سپس CRUSH مشخص میکند OSD Set مربوط به آن PG کدام OSDها هستند.
بنابراین PG بین Object و OSD قرار میگیرد و مدیریت Placement را سادهتر میکند.
تعداد PGها نیز اهمیت دارد.
PG بسیار کم میتواند باعث توزیع نامناسب داده شود و تعداد بیشازحد PG نیز سربار بیشتری برای Cluster ایجاد میکند.
در نسخههای جدید Ceph قابلیت PG Autoscaler نیز وجود دارد که میتواند در تنظیم مناسب تعداد PGها کمک کند.
CRUSH یکی از مهمترین مفاهیم معماری Ceph است.
CRUSH مخفف:
Controlled Replication Under Scalable Hashing
است.
وظیفه CRUSH تعیین محل قرارگیری داده در Cluster است.
در Storageهای سنتی معمولاً یک سیستم مرکزی اطلاعات مربوط به محل داده را نگهداری میکند.
Ceph رویکرد متفاوتی دارد.
Client با استفاده از Cluster Map و الگوریتم CRUSH میتواند محل قرارگیری داده را محاسبه کند.
به زبان ساده:
CRUSH تصمیم میگیرد داده روی کدام OSDها قرار بگیرد.
اما این تصمیم فقط بر اساس انتخاب تصادفی چند Disk انجام نمیشود.
CRUSH میتواند توپولوژی واقعی Datacenter را نیز در نظر بگیرد.
فرض کنیم سه Replica از یک داده داریم.
اگر هر سه Replica روی سه Disk مختلف ولی داخل یک Server قرار گرفته باشند، با خرابشدن آن Server هر سه نسخه همزمان از دسترس خارج میشوند.
اینجاست که مفهوم Failure Domain اهمیت پیدا میکند.
CRUSH میتواند ساختار فیزیکی زیرساخت را بشناسد.
برای مثال:
Datacenter
   ↓
Rack
   ↓
Host
   ↓
OSD
فرض کنیم Cluster ما این ساختار را دارد:
Rack-01
 ├── Host-01
 │    ├── OSD.0
 │    └── OSD.1
 │
 └── Host-02
      ├── OSD.2
      └── OSD.3

Rack-02
 ├── Host-03
 └── Host-04
اگر Failure Domain روی host تنظیم شده باشد، Ceph میتواند Replicaها را روی Hostهای مختلف قرار دهد.
در معماریهای بزرگتر حتی میتوان Failure Domain را بر اساس Rack طراحی کرد.
در نتیجه طراحی CRUSH Map یکی از بخشهای مهم طراحی Ceph در محیط Production است.
حالا اجزایی که تا اینجا بررسی کردیم را کنار هم قرار دهیم.
فرض کنیم یک Client میخواهد یک Object را داخل Ceph بنویسد.
در سطح مفهومی اتفاق زیر رخ میدهد:
مرحله اول: Client اطلاعات Cluster Map را در اختیار دارد.
مرحله دوم: داده داخل یک Pool قرار میگیرد.
مرحله سوم: Object به یک Placement Group نگاشت میشود.
مرحله چهارم: CRUSH بر اساس PG و CRUSH Map، OSDهای مناسب را مشخص میکند.
مرحله پنجم: Client با Primary OSD مربوطه ارتباط برقرار میکند.
مرحله ششم: داده بر اساس Policy مربوط به Pool روی OSDهای موردنیاز نوشته میشود.
مدل ساده آن:
Client
   ↓
Pool
   ↓
Object
   ↓
PG
   ↓
CRUSH
   ↓
Primary OSD
   ↓
Replica OSDs
این معماری یکی از تفاوتهای مهم Ceph با Storageهای متمرکز سنتی است.
در یک Storage Cluster بزرگ، خرابی Disk اتفاق عجیبی نیست.
در واقع معماری Ceph با این فرض طراحی شده که Hardware ممکن است خراب شود.
فرض کنیم یک Pool دارای Replication Size برابر 3 است.
یعنی Ceph سه نسخه از داده را طبق Policy مربوطه نگهداری میکند.
اگر یکی از OSDهای حاوی داده از دسترس خارج شود، Replicaهای دیگر همچنان وجود دارند.
اگر OSD برای مدت مشخصی خارج از Cluster باقی بماند، Ceph میتواند عملیات Recovery را آغاز کند و نسخههای موردنیاز را روی OSDهای سالم دیگر ایجاد کند.
در این شرایط Administrator باید وضعیت Cluster را بررسی کند.
یکی از اولین دستورها:
ceph -sاین دستور وضعیت کلی Cluster را نمایش میدهد.
برای مشاهده جزئیات Health:
ceph health detailبرای مشاهده وضعیت OSDها:
ceph osd statusو برای مشاهده ساختار OSD Tree:
ceph osd treeدر زمان Recovery باید ظرفیت Cluster، Network Traffic، تعداد PGهای Degraded و وضعیت OSDها بررسی شود.
یکی از روشهای حفاظت از داده در Ceph استفاده از Replication است.
فرض کنیم:
size = 3یعنی برای هر Object، سه Replica طبق Placement Policy نگهداری میشود.
اگر ۱ ترابایت داده منطقی داشته باشیم، در یک مثال ساده با Replication سهنسخهای تقریباً ۳ ترابایت Raw Capacity برای Replicaهای آن داده مصرف میشود؛ البته ظرفیت واقعی قابل استفاده Cluster به عوامل دیگری نیز وابسته است.
مزیت Replication سادگی و رفتار قابل پیشبینی آن است.
اما هزینه آن مصرف ظرفیت بیشتر است.
روش دیگر حفاظت از داده Erasure Coding است.
در این روش بهجای نگهداری چند نسخه کامل از داده، اطلاعات به Data Chunk و Coding Chunk تقسیم میشوند.
برای مثال یک Profile میتواند ساختاری مانند این داشته باشد:
k = 4
m = 2
یعنی چهار Data Chunk و دو Coding Chunk.
این روش میتواند نسبت به Replication فضای Storage کمتری مصرف کند، اما پیچیدگی و هزینه پردازشی بیشتری دارد و Performance و Recovery آن باید متناسب با Workload بررسی شود.
بنابراین نمیتوان گفت Erasure Coding همیشه بهتر از Replication است.
انتخاب بین این دو باید بر اساس مواردی مانند:
انجام شود.
یکی از نقاط مهم Ceph این است که یک Cluster میتواند چند مدل Storage ارائه کند.
RBD مخفف RADOS Block Device است.
از RBD برای ارائه Block Storage استفاده میشود.
این مدل در Virtualization و OpenStack بسیار کاربردی است.
برای مثال Cinder میتواند Volumeهای ماشینهای مجازی را روی Ceph RBD نگهداری کند.
RGW یا RADOS Gateway امکان ارائه Object Storage را فراهم میکند.
RGW میتواند APIهای Object Storage مانند S3-compatible API را ارائه دهد.
بنابراین Applicationها میتوانند دادههای Object خود را روی Ceph ذخیره کنند.
CephFS یک Distributed File System است.
برخلاف RBD که Block Storage ارائه میکند، CephFS یک File System توزیعشده در اختیار Clientها قرار میدهد.
در این بخش MDS نقش مهمی در مدیریت Metadata مربوط به File System دارد.
یکی از کاربردهای مهم Ceph، استفاده در زیرساخت OpenStack است.
Ceph میتواند با چند سرویس اصلی OpenStack یکپارچه شود.
برای مثال:
Glance
میتواند Imageهای سیستمعامل را روی Ceph ذخیره کند.
Cinder
میتواند Volumeهای ماشینهای مجازی را روی Ceph RBD ایجاد کند.
Nova
در برخی معماریها میتواند Disk مربوط به Instanceها را روی Ceph قرار دهد.
در نتیجه Storage ماشینهای مجازی به Local Disk یک Compute Node محدود نمیشود.
این موضوع در طراحی معماری Cloud، High Availability و جابهجایی Workloadها اهمیت زیادی دارد.
برای آشنایی بیشتر با معماری Cloud میتوانید بخش Private Cloud مبتنی بر OpenStack ابرپلاس را نیز مطالعه کنید.
نصب Ceph نسبتاً سادهتر از طراحی صحیح یک Ceph Cluster برای Production است.
در محیط واقعی باید قبل از Deployment چند موضوع بررسی شود.
تعداد Nodeها روی ظرفیت، Failure Domain و میزان تحمل خرابی تأثیر دارد.
باید مشخص شود Workload به HDD، SSD یا NVMe نیاز دارد.
Raw Capacity با ظرفیتی که واقعاً میتوان برای داده استفاده کرد یکسان نیست.
Replication، Erasure Coding و فضای آزاد موردنیاز برای Recovery باید در محاسبات لحاظ شوند.
Network یکی از بخشهای بسیار مهم Ceph است.
ترافیکهای مختلفی میتوانند روی شبکه وجود داشته باشند:
اگر Network نتواند این ترافیک را مدیریت کند، Performance Storage نیز تحت تأثیر قرار میگیرد.
باید مشخص شود خرابی چه Componentهایی قرار است تحمل شود.
Disk؟
Host؟
Rack؟
این تصمیم روی CRUSH Rule و معماری Cluster تأثیر مستقیم دارد.
Ceph Cluster باید دائماً Monitoring شود.
فقط وضعیت HEALTH_OK کافی نیست.
مواردی مانند:
باید بررسی شوند.
پاسخ این سؤال همیشه بله یا خیر نیست.
Ceph و SAN دو معماری متفاوت هستند.
SAN معمولاً بر پایه Storage Arrayهای متمرکز طراحی میشود، در حالی که Ceph یک Software-Defined Distributed Storage است.
انتخاب بین این دو باید بر اساس نیاز زیرساخت انجام شود.
برای مثال باید مواردی مانند:
بررسی شوند.
بنابراین استفاده از Ceph صرفاً به دلیل Open Source بودن یا قابلیت Scale-out تصمیم درستی نیست.
Ceph یک پلتفرم ذخیرهسازی توزیعشده است که میتواند Block Storage، Object Storage و File Storage را در اختیار زیرساخت قرار دهد.
در معماری Ceph، OSDها داده را نگهداری میکنند، MONها وضعیت Cluster را حفظ میکنند، MGR قابلیتهای مدیریتی و Monitoring را فراهم میکند و MDS در CephFS مسئول مدیریت Metadata است.
دادهها در Poolها سازماندهی میشوند، Objectها به Placement Groupها نگاشت میشوند و CRUSH بر اساس توپولوژی و Policy مشخص میکند داده روی چه OSDهایی قرار بگیرد.
اما طراحی Ceph فقط به تعداد Disk و Storage Node محدود نمیشود. Network، Failure Domain، Replication، Erasure Coding، ظرفیت موردنیاز برای Recovery، نوع Workload و Monitoring همگی باید در طراحی Production در نظر گرفته شوند.
برای بررسی تخصصی طراحی Storage Cluster، Capacity Planning و معماری Ceph میتوانید صفحه Ceph و Storage ابرپلاس را نیز مشاهده کنید.